Capítulo 3: El Bucle Infinito
Tenemos un problema.
Imagina ejecutar el script del Capítulo 2 dos veces. Dices “Mi nombre es Alice.” Claude te saluda. Lo ejecutas de nuevo y preguntas “¿Cuál es mi nombre?” Claude dice “No lo sé.”
Esto se debe a que los LLMs son sin estado. Tienen amnesia total. Cada solicitud es la primera vez que se han conocido.
Para construir un agente, necesitamos solucionar esto creando memoria artificial.
La Ilusión de la Memoria
La “memoria” en un LLM no es un disco duro. Es un archivo de registro.
Cuando chateas con ChatGPT, no “recuerda” lo que dijiste hace 5 minutos. Entre bastidores, el código envía el historial completo de la conversación al modelo con cada nuevo mensaje.
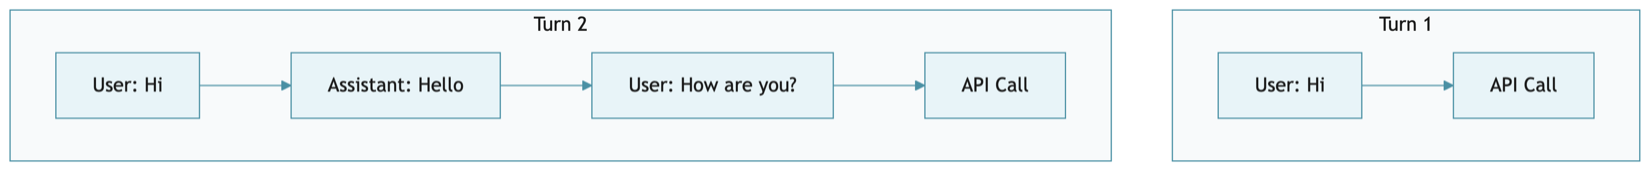
El modelo ve la transcripción completa cada vez. Ese es el truco.
Implementemos este bucle de contexto manualmente. Pero primero, necesitamos que nuestro código sea testeable.
El Problema de las Pruebas
Aquí va una verdad incómoda: no puedes probar una aplicación impulsada por un LLM llamando realmente al LLM.
Las llamadas a la API son lentas (de 2 a 10 segundos cada una), costosas (dinero real por llamada) y no deterministas (puedes obtener una respuesta diferente cada vez). Imagina ejecutar un conjunto de pruebas que cuesta 5 dólares y tarda 20 minutos. Nunca lo ejecutarías.
La solución es la inyección de dependencias. En lugar de codificar en duro la llamada a la API dentro de nuestro agente, pasamos un objeto “cerebro”. En producción, el cerebro es Claude. En las pruebas, el cerebro es un objeto simulado que devuelve respuestas predecibles.
Estableceremos este patrón ahora, antes de escribir más código de producción.
Tipos de Respuesta
Antes de construir el cerebro, necesitamos definir qué devuelve. La API de Claude envía JSON complejo con múltiples bloques de contenido. Necesitamos objetos Python simples con los que trabajar.
El Contexto: Claude puede devolver texto, llamadas a herramientas, o ambos en una sola respuesta. Necesitamos objetos de datos simples para representar estas posibilidades. (Omitimos @dataclass deliberadamente: estas clases son lo suficientemente simples como para que el decorador ahorre unas pocas líneas a costa de ocultar lo que __init__ hace realmente.)
El Código:
17 class ToolCall:
18     """A tool invocation request from the brain."""
19
20     def __init__(self, id, name, args):
21         self.id = id
22         self.name = name
23         self.args = args  # dict
ToolCall representa al cerebro pidiéndonos que ejecutemos una herramienta. El id es un identificador único para el seguimiento (Claude lo necesita cuando le devolvemos los resultados). El name indica qué herramienta ejecutar. El args es un diccionario de parámetros.
Todavía no usaremos ToolCall —el cerebro todavía no puede llamar herramientas— pero lo definimos ahora porque forma parte del tipo de respuesta Thought. Cuando agreguemos herramientas, Claude devolverá estos cuando quiera leer un archivo o ejecutar un comando.
26 class Thought:
27     """Standardized response from any Brain."""
28
29     def __init__(self, text=None, tool_calls=None, thinking=None):
30         self.text = text  # str or None
31         self.tool_calls = tool_calls or []  # list of ToolCall
32         self.thinking = thinking  # str or None
Un Thought es lo que el cerebro devuelve después de pensar. Puede contener texto, llamadas a herramientas, ambos, o ninguno. El campo thinking captura el resumen del razonamiento del modelo — veremos de dónde viene eso cuando construyamos la clase Claude más adelante. Esta abstracción nos permitirá reemplazar Claude por DeepSeek en el futuro sin modificar ningún otro código.
El patrón FakeBrain
Ahora podemos construir un cerebro falso para las pruebas.
El contexto: Necesitamos un cerebro que devuelva respuestas predecibles, registre cuántas veces fue llamado y registre la conversación que recibió.
El código:
class FakeBrain:
    """Fake brain for testing - returns predictable responses."""

    def __init__(self, responses=None):
        self.responses = responses or [Thought(text="Fake response")]
        self.call_count = 0
        self.last_conversation = None

    def think(self, conversation):
        self.last_conversation = list(conversation)  # Store a copy
        if self.call_count < len(self.responses):
            response = self.responses[self.call_count]
            self.call_count += 1
            return response
        return Thought(text="No more responses")
Esto va en test_nanocode.py, no en el código de producción. Observa que FakeBrain tiene la misma interfaz que tendrá nuestro cerebro real: un método think() que recibe una conversación y devuelve un Thought.
 |
Aparte: Este patrón —reemplazar una dependencia real con un falso predecible para las pruebas— se llama doble de prueba. El artículo de Martin Fowler “Mocks Aren’t Stubs”1 explica las variaciones (fakes, stubs, mocks, spies). Para las pruebas de LLM, un fake simple con respuestas prefabricadas suele ser todo lo que necesitas. |
Definición del éxito
Antes de escribir el código de producción, definamos cómo se ve el éxito. Estas pruebas guiarán nuestra implementación.
Prueba 1: El cerebro devuelve una respuesta
1 def test_handle_input_returns_brain_response():
2     """Verify handle_input returns the brain's response text."""
3     brain = FakeBrain(responses=[Thought(text="Hello from brain!")])
4     agent = Agent(brain=brain)
5     result = agent.handle_input("hi")
6     assert result == "Hello from brain!"
Observa que pasamos brain=brain al Agent. Esto es la inyección de dependencias en acción.
Test 2: La conversación se acumula
 1 def test_conversation_accumulates():
 2     """Verify conversation list grows with each interaction."""
 3     brain = FakeBrain(responses=[
 4         Thought(text="Response 1"),
 5         Thought(text="Response 2")
 6     ])
 7     agent = Agent(brain=brain)
 8
 9     agent.handle_input("First message")
10     assert len(agent.conversation) == 2  # user + assistant
11
12     agent.handle_input("Second message")
13     assert len(agent.conversation) == 4  # 2 users + 2 assistants
Después de cada intercambio, la conversación debe contener tanto el mensaje del usuario como la respuesta del asistente.
Prueba 3: Estructura de mensaje correcta
 1 def test_conversation_contains_correct_roles():
 2     """Verify conversation has correct role alternation."""
 3     brain = FakeBrain(responses=[Thought(text="AI response")])
 4     agent = Agent(brain=brain)
 5
 6     agent.handle_input("User message")
 7
 8     assert agent.conversation[0]["role"] == "user"
 9     assert agent.conversation[0]["content"] == "User message"
10     assert agent.conversation[1]["role"] == "assistant"
11     assert agent.conversation[1]["content"] == "AI response"
Los mensajes deben tener el formato exacto que Claude espera: {"role": "user", "content": "..."}.
Test 4: Brain recibe la conversación
 1 def test_brain_receives_conversation():
 2     """Verify brain.think is called with the conversation list."""
 3     brain = FakeBrain()
 4     agent = Agent(brain=brain)
 5
 6     agent.handle_input("Test message")
 7
 8     assert brain.last_conversation is not None
 9     assert len(brain.last_conversation) == 1
10     assert brain.last_conversation[0]["content"] == "Test message"
El cerebro debe recibir la conversación completa, no solo el mensaje actual.
Ejecuta estas pruebas ahora—todas deberían fallar:
1 pytest test_nanocode.py -v
1 FAILED test_nanocode.py::test_handle_input_returns_brain_response
2 FAILED test_nanocode.py::test_conversation_accumulates
3 ...
Bien. Ahora hagamos que pasen.
La Clase Claude
Ahora viene el verdadero cerebro.
El Contexto: Necesitamos una clase que envuelva la API de Claude. Debe gestionar la autenticación, enviar el historial de conversación y convertir la respuesta en un Thought. También habilitamos el pensamiento extendido: una característica por la que el modelo escribe apuntes internos antes de responder. Imagínalo como el modelo hablándose a sí mismo en un bloc de notas antes de hablar. Cuesta tokens adicionales, pero la mejora en calidad es significativa, especialmente cuando añadamos herramientas en el Capítulo 5, donde el modelo necesita razonar sobre qué herramienta usar y por qué.
El Código:
37 class Claude:
38     """Claude API - the brain of our agent."""
39
40     def __init__(self):
41         self.api_key = os.getenv("ANTHROPIC_API_KEY")
42         if not self.api_key:
43             raise ValueError("ANTHROPIC_API_KEY not found in .env")
44         self.model = "claude-sonnet-4-6"
45         self.url = "https://api.anthropic.com/v1/messages"
46
47     def think(self, conversation):
48         headers = {
49             "x-api-key": self.api_key,
50             "anthropic-version": "2023-06-01",
51             "content-type": "application/json"
52         }
53         payload = {
54             "model": self.model,
55             "max_tokens": 16000,
56             "thinking": {
57                 "type": "enabled",
58                 "budget_tokens": 10000
59             },
60             "messages": conversation
61         }
62
63         response = requests.post(self.url, headers=headers, json=payload, timeout=120)
64         response.raise_for_status()
65         return self._parse_response(response.json()["content"])
El Recorrido:
- Líneas 41-43: Carga la clave de API y falla de inmediato si no está presente.
- Líneas 44-45: Almacena la configuración. Más adelante haremos que el modelo sea configurable.
- Línea 47: El método
think()es la interfaz del cerebro—igual que enFakeBrain. - Líneas 55-59: Habilitamos el extended thinking—el modelo produce un resumen de razonamiento antes de responder, lo que mejora la calidad en tareas complejas a costa de más tokens.
budget_tokenslimita la cantidad de tokens que el modelo puede gastar en razonamiento (10.000 aquí)—esos tokens cuentan en tu factura igual que los tokens de salida. En nuestra configuración,max_tokenscubre el total de la salida, incluyendo tanto el razonamiento como la respuesta, por lo que Anthropic requiere que supere abudget_tokens. Con 10.000 tokens de razonamiento y 16.000 de máximo, la respuesta en sí puede usar hasta 6.000 tokens. - Línea 60: El payload incluye
"messages": conversation—el historial completo, no solo el mensaje actual. Este es el bucle de contexto. - Línea 65: Analiza el complejo formato de respuesta de Claude y lo convierte en nuestro sencillo
Thought.
Ahora el analizador de respuestas:
67     def _parse_response(self, content):
68         """Convert Claude's response format to Thought."""
69         text_parts = []
70         tool_calls = []
71         thinking = None
72
73         for block in content:
74             if block["type"] == "thinking":
75                 thinking = block["thinking"]
76             elif block["type"] == "text":
77                 text_parts.append(block["text"])
78             elif block["type"] == "tool_use":
79                 tool_calls.append(ToolCall(
80                     id=block["id"],
81                     name=block["name"],
82                     args=block["input"]
83                 ))
84
85         return Thought(
86             text="\n".join(text_parts) if text_parts else None,
87             tool_calls=tool_calls,
88             thinking=thinking
89         )
La API de Claude devuelve una lista de “bloques de contenido”. Cada bloque tiene un type—"thinking", "text" o "tool_use". El bloque de pensamiento llega primero y contiene un resumen del razonamiento del modelo; lo almacenamos en el Thought para que quien lo invoque pueda mostrarlo. Los bloques de texto se convierten en la respuesta, y los bloques tool_use se convierten en objetos ToolCall. El parser no imprime nada; simplemente convierte el JSON sin procesar en un Thought limpio.
La Clase Agent (Actualizada)
Ahora actualizamos el Agent del Capítulo 1 para que acepte un cerebro y mantenga el historial de conversación.
El Código:
 94 class Agent:
 95     """A coding agent with conversation memory."""
 96
 97     def __init__(self, brain):
 98         self.brain = brain
 99         self.conversation = []
100
101     def handle_input(self, user_input):
102         """Handle user input. Returns output string, raises AgentStop to quit."""
103         if user_input.strip() == "/q":
104             raise AgentStop()
105
106         if not user_input.strip():
107             return ""
108
109         self.conversation.append({"role": "user", "content": user_input})
110
111         try:
112             thought = self.brain.think(self.conversation)
113             if thought.thinking:
114                 lines = thought.thinking.strip().split("\n")[:5]
115                 for i, line in enumerate(lines):
116                     prefix = "  💭 " if i == 0 else "     "
117                     print(f"\033[2m{prefix}{line}\033[0m")
118             text = thought.text or ""
119             self.conversation.append({"role": "assistant", "content": text})
120             return text
121         except Exception as e:
122             self.conversation.pop()  # Remove failed user message
123             return f"Error: {e}"
El recorrido:
- Líneas 97-99: Acepta un cerebro mediante inyección de dependencias. Inicializa una lista de conversación vacía.
- Línea 109: Agrega el mensaje del usuario al historial antes de llamar al cerebro.
- Líneas 112-120: Llama al cerebro, muestra hasta cinco líneas de pensamiento en texto atenuado (
\033[2mes el código de escape ANSI para atenuar,\033[0mlo restablece), extrae la respuesta y la agrega al historial. - Líneas 121-123: Si la llamada a la API falla, elimina el mensaje del usuario que acabamos de agregar. Esto mantiene la conversación en un estado válido.
Presta atención a la línea 109: agregamos el mensaje del usuario antes de llamar al cerebro. El cerebro necesita ver la conversación completa, incluido el mensaje actual.
El Bucle Principal (Actualizado)
El bucle principal ahora es simplemente una capa delgada de E/S:
128 def main():
129     brain = Claude()
130     agent = Agent(brain)
131     print("⚡ Nanocode v0.2 (Conversation Memory)")
132     print("Type '/q' to quit.\n")
133
134     while True:
135         try:
136             user_input = input("❯ ")
137             output = agent.handle_input(user_input)
138             if output:
139                 print(f"\n{output}\n")
140
141         except (AgentStop, KeyboardInterrupt):
142             print("\nExiting...")
143             break
144
145
146 if __name__ == "__main__":
147     main()
Toda la lógica está en la clase Agent. El bucle simplemente lee la entrada, llama a handle_input() e imprime el resultado. Esta separación hace que el agente sea testeable: probamos Agent.handle_input() directamente sin necesidad de simular input() ni print().
Verifica que las pruebas pasen
Ejecuta las pruebas de nuevo:
1 pytest test_nanocode.py -v
1 test_nanocode.py::test_handle_input_returns_brain_response PASSED
2 test_nanocode.py::test_conversation_accumulates PASSED
3 test_nanocode.py::test_conversation_contains_correct_roles PASSED
4 test_nanocode.py::test_brain_receives_conversation PASSED
Todo en verde. Las pruebas verifican nuestra implementación sin realizar una sola llamada a la API.
Probar la Memoria
Ahora prueba con el cerebro real:
1 python nanocode.py
Prueba esta conversación:
 1 ❯ I am building a Python agent.
 2   💭 The user is telling me about their project. They want to build
 3      a Python agent. I should respond helpfully and ask what kind
 4      of agent they're building.
 5
 6 That sounds exciting! What kind of agent are you building?
 7
 8 ❯ What language am I using?
 9   💭 The user previously said they are building a Python agent.
10      The answer is Python.
11
12 You are using Python.
La lista de conversación está haciendo su trabajo.
El Problema de la Ventana de Contexto
Quizás estés pensando: “¿Puedo mantener esto corriendo para siempre?”
No.
En cada iteración del bucle, la lista messages crece:
| Turno | Tokens Aproximados |
|---|---|
| 1 | 50 |
| 10 | 5.000 |
| 100 | 50.000 |
En algún momento, alcanzas el límite de contexto—200k tokens para Claude Sonnet, 128k para DeepSeek, y tan solo 4k en algunos modelos locales. Si lo superas, la API devuelve 400 Bad Request. Nuestro manejo de errores en la línea 121 captura esto e informa el error, así que el agente no fallará en silencio. Pero la conversación queda efectivamente bloqueada—cada mensaje posterior también fallará, ya que el historial sigue siendo demasiado largo.
Por ahora, reiniciar el agente borra el historial y te permite retomar el hilo. Añadiremos la compactación de contexto adecuada—rastreando el uso de tokens desde la respuesta de la API y resumiendo automáticamente los mensajes antiguos antes de que se desborden—cuando construyamos el bucle de retroalimentación en el Capítulo 9. Ahí es donde las conversaciones realmente explotan, y donde la solución se ganará su lugar.
Conclusión
Claude ahora recuerda—o más bien, lo hemos engañado para que crea que recuerda. La lista de conversación crece con cada turno, y FakeBrain nos permite probar todo el sistema sin gastar un centavo.
Ambos patrones se mantendrán a lo largo del resto del libro. Cada cerebro que construyamos (Claude, DeepSeek, Ollama) implementará la misma interfaz think(), y FakeBrain los probará a todos.
Un cabo suelto: nuestro código está cableado directamente a la API de Anthropic. Si quisiéramos añadir DeepSeek o un modelo local, tendríamos que duplicar una gran cantidad de código.
https://martinfowler.com/articles/mocksArentStubs.html↩︎