EXACT Coding
Beyond Vibe Coding: Der Software-Craft-Ansatz für Agentic Development
Disclaimer
Exact Coding ist nichts grundlegend Neues. Es ist ein Workflow, der aus über 20 Jahren bewährter Softwareentwicklung schöpft und diese Techniken zu einem Paket bündelt, das gut mit Agentic Coding funktioniert.
Neu ist allein, wie diese Techniken zusammengestellt und erprobt werden — mit dem Ziel, einen Workflow zu finden, der die Möglichkeiten von Agentic Coding ausschöpft, ohne zu unkontrolliertem „Vibe Coding“ mit niedriger Codequalität zu verleiten. Im Mittelpunkt steht hochqualitativer Code, der exakt die User-Anforderungen erfüllt.
Man könnte es eine langweilige Technik nennen — die aber sehr gut funktioniert. Exact Coding ist aus eigenen Experimenten der Autoren entstanden und kommt mittlerweile auch in Kundenprojekten zum Einsatz.
Updates
Dieses Buch wächst mit der Zeit und wird fortlaufend weiterentwickelt. Informationen zu neuen Inhalten und Versionen erscheinen auf Leanpub und auf den LinkedIn-Profilen der Autoren.
 |
Dieses Buch befindet sich noch in der Entstehung. Es erscheint nach dem Leanpub-Prinzip des „In-Progress Publishing“ — wir veröffentlichen also bereits, während wir noch schreiben. Einzelne Kapitel können daher unvollständig sein, sich noch ändern oder später hinzukommen. Wer das Buch jetzt liest, erhält alle künftigen Aktualisierungen automatisch und kostenlos über Leanpub. Gerade weil das Buch noch wächst, ist euer Feedback besonders wertvoll — Hinweise und Anmerkungen nehmen wir jederzeit gern auf (siehe Kontakt und Feedback). Stand dieser Version: Juli 2026. |
Einführung
Das Ziel war von Beginn an klar: KI-unterstützte Softwareentwicklung produktiv nutzbar machen. Der prominenteste Ansatz dafür ist das sogenannte ‚Vibe Coding‘, ein Begriff, den Andrej Karpathy im Februar 2025 prägte — ein Datum, das in der rasanten Welt des Agentic Coding heute fast schon als Steinzeit gilt.
In diesem vielbeachteten Tweet erklärt er, wie Vibe Coding funktioniert: Man gibt sich den „Vibes“ hin („give in to the vibes“) und vergisst, dass der Code überhaupt existiert. Fehlermeldungen werden kommentarlos per Copy & Paste übernommen. Die Folge: Der Code wächst schnell über das Verständnis des Entwicklers hinaus. Karpathy selbst merkt allerdings an, dieser Ansatz sei „nicht allzu schlecht für Wegwerfprojekte an Wochenenden“. Damit schränkt er den Anwendungsbereich deutlich ein: Vibe Coding eignet sich für experimentelle Wochenendprojekte, nicht jedoch für Software, die produktiv gehen soll.
Realitätscheck: Wenn der Vibe kippt
Unkontrolliertes Vibe Coding führt in der Praxis schnell zu massiven Qualitätsproblemen. Sobald die anfängliche Euphorie verfliegt und der Code produktiv genutzt werden soll, treten oft gravierende Mängel zutage.
Mehrere prominente Fälle zeigen dieses Scheitern:
Der Fall Leo (@leojr94_), März 2025: Ein Entwickler baute ein SaaS-Produkt komplett mit Cursor („zero hand written code“). Kurz nach dem Start war das Projekt massiven Angriffen ausgesetzt: Das Bezahlsystem wurde umgangen, die Datenbank zugemüllt und API-Kosten explodierten. Da der Entwickler den generierten Code nicht verstand, konnte er die Lücken nicht schließen und musste das Projekt abschalten.
Base44 SaaS Vorfall (2025): Eine rein KI-generierte Komponente führte zu einer kritischen Sicherheitslücke. Nicht authentifizierte Nutzer konnten Autorisierungsmechanismen umgehen und direkt auf interne Geschäftslogik zugreifen.
Replit Datenbank-Unfall: Ein KI-generiertes Wartungsskript löschte versehentlich eine komplette Produktionsdatenbank. Der generierte Löschbefehl war zu aggressiv und enthielt keinerlei Sicherheitsabfragen.
Typische Qualitätsmängel
Neben solchen Einzelfällen leiden Vibe-Coding-Projekte häufig unter systematischen Qualitätsproblemen, die Wartbarkeit und Sicherheit gefährden:
- Hardcoded Secrets: API-Keys oder Passwörter landen direkt im Quelltext, statt in Umgebungsvariablen. Sobald der Code in ein Repository gelangt, sind diese sensiblen Daten kompromittiert. Eine Untersuchung von Truffle Security zeigt, dass die meisten LLMs aktiv dazu anleiten, API-Keys direkt im Code zu hinterlegen, anstatt Umgebungsvariablen zu nutzen.
- Client-Side Security: Kritische Sicherheitslogik wird fälschlicherweise ins Frontend verlagert (z. B. Admin-Checks im JavaScript), wo sie von jedem Nutzer manipuliert werden kann. Eine Analyse von Akinciborg ergab, dass vibe-codierte Anwendungen drei- bis fünfmal mehr Sicherheitslücken aufweisen als traditionell entwickelte Software.
- Halluzinierte Dependencies: Die KI importiert Bibliotheken, die nicht existieren oder falsch geschrieben sind. Dies öffnet Einfallstore für Supply-Chain-Attacken — ein Angriffsvektor, der inzwischen als „Slopsquatting“ bekannt ist. Laut einer Studie halluzinieren kommerzielle LLMs Paketnamen mit einer Rate von etwa 5 %, Open-Source-Modelle sogar mit über 20 %.
- Fehlende Input-Validierung: Da die KI oft nur den „Happy Path“ berücksichtigt, werden Nutzereingaben ungeprüft übernommen, was zu klassischen Schwachstellen wie SQL-Injection führt. Eine groß angelegte Analyse von über 7.700 KI-generierten Dateien auf GitHub fand in 12 % des Codes identifizierbare Sicherheitslücken.
- Überentwicklung: Wird die KI nicht gezielt eingeschränkt, neigt sie dazu, weit über die eigentlichen Anforderungen hinauszuschießen — es werden mehr Features implementiert als gefordert, was die Komplexität unnötig erhöht und die Wartbarkeit verschlechtert. Wie eine Analyse auf UX Design beschreibt, erzeugt Vibe Coding durch seinen spielerischen Charakter eine Dynamik, die zum ständigen Weiteriterieren verleitet — weit über den ursprünglichen Scope hinaus.
- Uneinheitliche Implementierung: KI-generierter Code leidet häufig unter inkonsistenten Mustern und Konventionen. Unterschiedliche Prompts oder Kontextwechsel führen dazu, dass derselbe Sachverhalt an verschiedenen Stellen unterschiedlich gelöst wird — ein Problem, das mit wachsender Codebasis immer gravierender wird. Eine empirische Untersuchung belegt, dass LLM-generierter Code durchschnittlich 63 % mehr Code Smells aufweist als professionell geschriebener Code.
Der Autonomy-Slider und die Suche nach dem Sweet Spot
Angesichts dieser Risiken führt kein Weg daran vorbei, über Alternativen nachzudenken und etablierte Konzepte der Softwareentwicklung zu nutzen, die sich in den letzten 30 Jahren für hochqualitative Software bewährt haben.
Ein hilfreiches mentales Modell für den Einstieg ist der sogenannte „Autonomy Slider“, ein weiteres Konzept von Andrej Karpathy (vorgestellt in seinem Talk „Software Is Changing (Again)“). Die Grundidee ist simpel: Auf der linken Seite steht komplett handgeschriebener Code — hohe Qualität, aber geringste Produktivität. Auf der rechten Seite befindet sich Vibe Coding mit maximaler KI-Autonomie — hohe Produktivität, aber oft niedriges Qualitätsniveau. Dazwischen sind Abstufungen möglich; die Wahl des Kompromisses liegt beim Entwicklungsteam.
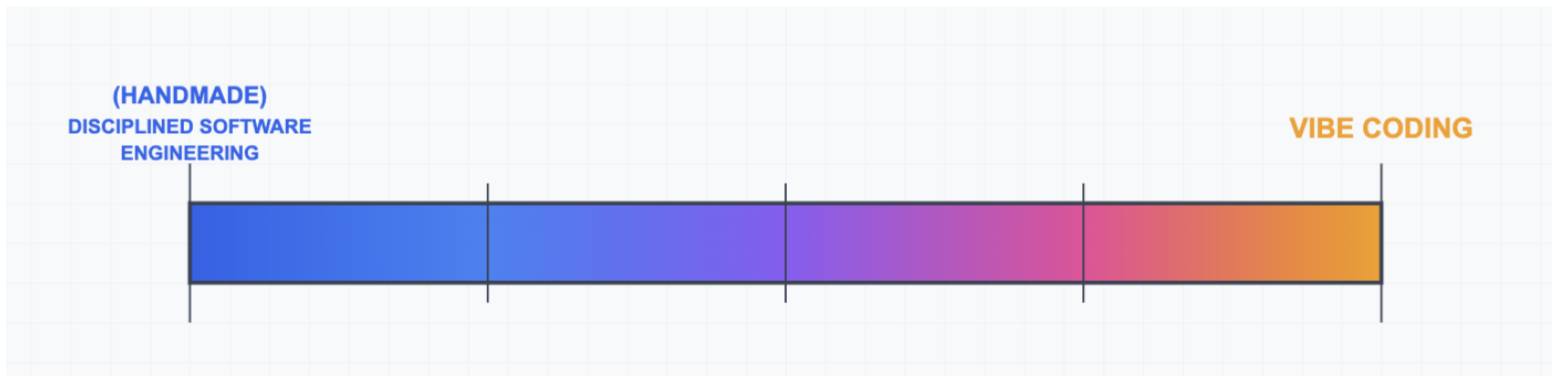
Die Stärke des Modells liegt darin, sichtbar zu machen, dass nicht jede Aufgabe denselben Autonomiegrad verträgt. Für unterschiedliche Aufgaben sind unterschiedliche Slider-Stellungen sinnvoll. Ivan Kusalic illustriert das in „DevAI: Beyond Hype and Denial“ mit einem Spektrum, das jeder Vorgehensweise eine passende Art von Aufgabe zuordnet:
- handgeschrieben — sicherheitskritische Authentifizierungslogik, Kern-Algorithmen
- handgeschrieben, KI-verbessert — komplexe Geschäftslogik
- KI-geschrieben, manuell editiert — Feature-Gerüste, API-Endpunkte
- KI-geschrieben, menschlich reviewt — Standard-CRUD-Operationen
- KI-generiert, KI-getestet — Utility-Funktionen, einfache Datentransformationen
- KI-generiert ohne Review — Wegwerf-Prototypen, Spikes
Diese konkrete Zuordnung ist allerdings nur eine Momentaufnahme: Mit jedem leistungsfähigeren Modell verschiebt sie sich nach rechts — Aufgaben, die heute noch menschliche Hand verlangen, lassen sich morgen schon zuverlässig der KI überlassen. Die obige Liste ist in Teilen bereits überholt. Das Prinzip bleibt davon unberührt: den Regler bewusst je Aufgabe wählen, statt ihn pauschal auf eine einzige Position zu stellen.
Die Grenzen des einfachen Sliders
So eingängig das Bild ist — als alleinige Entscheidungsgrundlage greift der Slider zu kurz. Vier Schwächen treten dabei zutage.
Produktivität ist nicht gleich Coding-Geschwindigkeit. Der Slider legt nahe, dass schnelleres Erzeugen von Code gleichbedeutend mit höherer Produktivität sei. Doch beides fällt auseinander. Sandro Mancuso bringt es in „Software Craftsmanship in the AI Era“ auf den Punkt: „True productivity in software isn’t about how many lines of code are produced, or how quickly they’re typed.“ Entscheidend sei stattdessen, wertvolle und wartbare Software mit möglichst wenig Reibung, Nacharbeit und Risiko auszuliefern. Dazu passt eine randomisiert-kontrollierte Studie von METR (Juli 2025): Erfahrene Open-Source-Entwickler waren mit KI-Werkzeugen 19 % langsamer — obwohl sie selbst erwartet hatten, 24 % schneller zu sein. Ein wesentlicher Grund: Entwickler verbringen ohnehin nur einen kleinen Teil ihrer Zeit mit dem Tippen von Code; der Großteil entfällt auf Lesen, Verstehen und Navigieren — genau dort setzt reine Tippgeschwindigkeit gar nicht an.
Die Achsen sind multidimensional. Qualität und Produktivität werden als zwei saubere Skalen dargestellt — tatsächlich bündelt jede von ihnen viele, teils gegenläufige Größen. Hinter „Qualität“ stehen etwa Korrektheit, Wartbarkeit, Sicherheit, Performance oder Lesbarkeit; hinter „Produktivität“ z. B. Durchsatz, Time-to-Market, Nacharbeit oder Risiko. Eine einzelne Schiebereglerstellung kann dieses Geflecht nicht abbilden: Was eine Dimension verbessert, kann eine andere verschlechtern.
Es bleibt offen, was überhaupt gemessen wird. Die Achsen „Qualität“ und „Produktivität“ klingen eingängig, sind aber schwer zu definieren und noch schwerer zu messen. Ohne klare Metriken bleibt jede Slider-Position letztlich Bauchgefühl.
Der Verlauf ist nicht linear. Bei einer Bewegung von links nach rechts steigt die Produktivität, ohne dass zwingend im gleichen Maße Qualität verloren geht. Durch den gezielten Einsatz bestimmter Techniken lässt sich auch bei höherer KI-Autonomie die Qualität sichern. Umgekehrt garantiert auch das linke Ende keine perfekte Qualität: Handgeschriebener Code — ganz ohne KI-Autonomie — kann ebenso Fehler, schlechtes Design oder Sicherheitslücken enthalten. Hohe Qualität ist also keine automatische Folge geringer Autonomie. Die Herausforderung besteht darin, einen „Sweet Spot“ zu finden: einen optimalen Trade-off, der eine spürbar höhere Produktivität ermöglicht, ohne dabei signifikante Qualitätseinbußen in Kauf nehmen zu müssen.
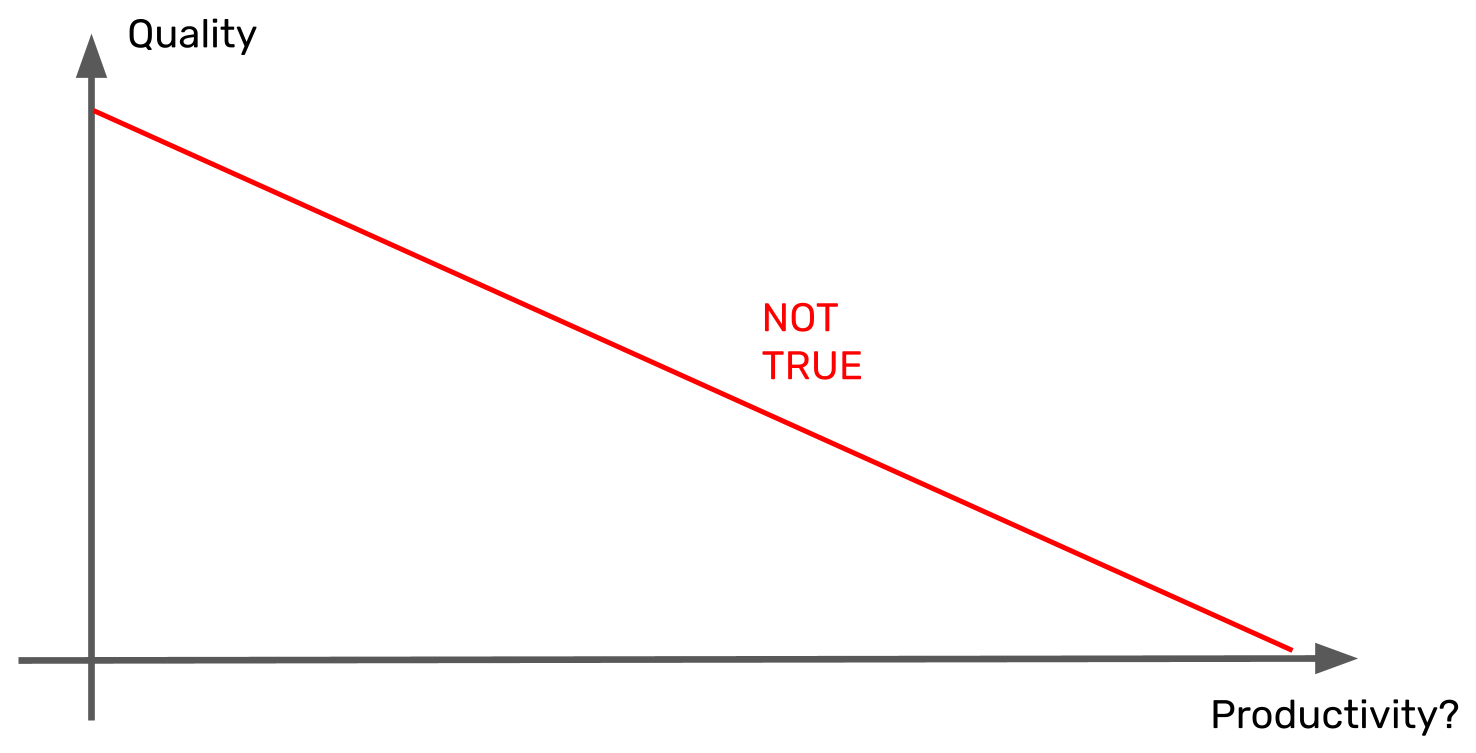
Der Autonomy Slider bleibt damit ein nützliches mentales Modell: Als Metapher stößt er zwar an die genannten Grenzen, doch seine Kernidee trägt — der Autonomiegrad lässt sich bewusst regeln.
Deshalb versuchen wir gar nicht erst, Produktivität und Qualität in all ihren Dimensionen exakt zu definieren und zu vermessen. Unsere Methode setzt am aktuellen Stand an und sucht von dort nach Wegen, Produktivität und/oder Qualität zu steigern.
Der Problemraum: Warum KI-Code oft an Qualität verliert
Bevor konkrete Lösungen betrachtet werden, lohnt sich ein Blick auf die Ursachen: Warum erzeugt Agentic Coding oft Code von geringerer Qualität? Ein zentrales Problem lässt sich unter den Stichworten Fokus und Limited Scope zusammenfassen.
Das Grundproblem liegt in der Funktionsweise aktueller LLMs, insbesondere bei großen Kontextfenstern. Wenn zu viele Informationen auf einmal verarbeitet werden müssen, gehen Details verloren — oft genau jene, die für die korrekte Implementierung einer Funktion entscheidend wären. Was hier fehlt, ist der Fokus: Das LLM muss in die Lage versetzt werden, sich ausschließlich mit der aktuell relevanten Aufgabe zu befassen, ohne durch „Hintergrundrauschen“ abgelenkt zu werden.
Lost in the Middle
Ein gut erforschtes Phänomen ist das sogenannte „Lost in the Middle“-Problem. Wie im Paper „Lost in the Middle: How Language Models Use Long Contexts“ von Liu et al. (2023) beschrieben, haben Large Language Models (LLMs) Schwierigkeiten, relevante Informationen zu nutzen, wenn diese in der Mitte eines langen Kontextfensters versteckt sind. Die Performance-Kurve ähnelt dabei oft einem „U“: Informationen am Anfang (Primacy) und am Ende (Recency) des Inputs werden gut verarbeitet, während Details in der Mitte oft „vergessen“ oder ignoriert werden.
Dies deckt sich mit den Beobachtungen aus den bekannten „Needle In A Haystack“-Tests, die visuell eindrücklich zeigen, wie Modelle bei steigender Kontextlänge Schwierigkeiten bekommen, spezifische Fakten („Nadeln“) aus großen Datenmengen („Heuhaufen“) korrekt zu extrahieren.
Limited Scope als Notwendigkeit
Auch aus der Praxis kommen ähnliche Warnungen. Chelsea Troy, Dozentin und Software Engineer bei Mozilla, betont in ihren Analysen (siehe What can we expect of LLMs as Software Engineers?), dass LLMs ihre Stärken vor allem dann ausspielen, wenn Probleme spezifisch und im Umfang begrenzt („limited in scope“) sind. Sobald der Kontext zu breit wird oder komplexe, projektübergreifende Abhängigkeiten erfordert, sinkt die Verlässlichkeit der KI rapide. Der Versuch, ganze Systeme „in einem Rutsch“ generieren zu lassen, führt daher fast zwangsläufig in die Qualitätsfalle.
Missing Human Judgment & Verification Debt
Neben dem fehlenden Fokus leiden LLMs unter einem weiteren fundamentalen Defizit: Missing Human Judgment. Ein LLM versteht nicht wirklich, was es tut; es erkennt Muster und Wahrscheinlichkeiten, aber keinen logischen Kontext für kritische Entscheidungen.
- Kein Verständnis für Sicherheit: Wie Sicherheitsforscher warnen (siehe z. B. ITPro), generieren Modelle zwar syntaktisch korrekten Code, übersehen aber oft sicherheitskritische Aspekte wie SQL-Injections oder fehlende Zugriffskontrollen. Der Code sieht richtig aus, ist aber nicht sicher.
- Verification Debt & Selbstüberschätzung: Studien, wie z. B. die in LiveScience zitierte Untersuchung, deuten darauf hin, dass intensive KI-Nutzung den Dunning-Kruger-Effekt verstärken kann. Weil der generierte Code auf den ersten Blick überzeugend wirkt, neigen Entwickler dazu, ihre Überprüfungen zurückzufahren („Verification Debt“). Es wird zu sehr auf das Tool vertraut, und das eigene Verständnis der generierten Lösung wird überschätzt.
- Fehlender Thought Process: Dem KI-Code fehlt der menschliche Entscheidungsprozess („Warum wurde das so gelöst?“). Das erhöht die kognitive Last beim Review massiv, da erst mühsam rekonstruiert werden muss, ob die Lösung wirklich zum Problem passt.
- Comprehension Debt: Die Folge vom vorherigen Punkt, denn: Normalerweise entsteht mit der Zeit ein mentales Modell in den Köpfen der Entwickler, weil sie sich mit der Domäne beschäftigt und viele Probleme gelöst haben. Wenn das fehlt, droht die sog. Comprehension Debt, also Verständnislücke. Wenn also eine Weile mit Verification Debt und fehlendem Thought Process gearbeitet wird, führt das zu Comprehension Debt - selbst wenn versucht wird, Code genau zu reviewen, haben die Entwickler nicht das mentale Modell, um Fehler überhaupt zu erkennen.
Der Mensch als Korrektiv: Human in the Loop
Viele Entwickler, die Agentic Coding nutzen, aber Vibe Coding ablehnen, setzen daher auf das Prinzip „Human in the Loop“ (HITL). Dass dies notwendig ist, zeigen Daten aus der Praxis: Ein Bericht von CodeRabbit fand beispielsweise signifikant mehr Issues in KI-generierten Pull Requests (durchschnittlich 10,83) im Vergleich zu rein menschlichen (6,45).
Auch Branchengrößen wie Atlassian betonen in der Vorstellung ihres HULA Frameworks, wie wichtig es ist, Automatisierung mit menschlicher Kontrolle zu kombinieren („keeping engineers in control“). Der Mensch bleibt die letzte Instanz, die Qualität, Sicherheit und Kontext bewertet — eine Rolle, die die KI (noch) nicht übernehmen kann.
Dabei spielt der Zeitpunkt des Feedbacks eine entscheidende Rolle. Eine Analogie aus der Navigation verdeutlicht das: Ein Kompassfehler von nur 5 Grad fällt nach 100 Metern kaum auf – nach 1.000 Metern liegt das Ziel jedoch bereits rund 87 Meter seitlich versetzt. Je länger die KI ohne menschliches Feedback arbeitet, desto größer wird die potenzielle Abweichung. Schnelles, frühes Feedback mag sich deshalb erstmal nach mehr Arbeit anfühlen, erspart aber langfristig oftmals zeitintensive Nacharbeiten.
Mehrdeutigkeit natürlicher Sprache
Ein weiteres fundamentales Problem liegt im Medium selbst: Programmiersprachen wurden entwickelt, um präzise zu sein. Natürliche Sprache hingegen ist von Natur aus vage und mehrdeutig. Wer mit Vibe Coding arbeitet und Anforderungen in natürlicher Sprache formuliert, setzt sich diesem Spannungsfeld voll aus.
Aktuelle Forschung bestätigt die Tragweite dieses Problems. Wie das Paper „When Prompts Go Wrong“ zeigt, führen selbst kleine Unklarheiten oder widersprüchliche Anweisungen in Task-Beschreibungen zu erheblichen Leistungseinbußen bei LLMs — darunter zahlreiche logische Fehler im generierten Code.
Das Kernproblem: Entwickler können selten alle Anforderungen vollständig und eindeutig spezifizieren — und selbst wenn sie es versuchen, interpretieren LLMs dieselben Worte oft anders als beabsichtigt. Ein Forschungsansatz („Can Code Language Models Learn Clarification-Seeking Behaviors?“) schlägt vor, Modelle darauf zu trainieren, bei Mehrdeutigkeiten aktiv nachzufragen. Doch solange dies nicht Standard ist, bleibt die Lücke zwischen natürlichsprachlicher Intention und generiertem Code eine permanente Fehlerquelle.
Der Lösungsraum: Bewährte Methoden neu entdeckt
In über zwei Jahrzehnten haben sich im Bereich der “Software Craft”-Bewegung zahlreiche Methoden entwickelt und etabliert, die sich auch im Kontext von Agentic Coding anwenden lassen. Dabei ist ein zentraler Punkt zu beachten: KI wirkt als Multiplikator (siehe auch den Artikel auf Substack). Werden schlechte Software-Praktiken mit KI umgesetzt, wird schlicht schnell schlechter Code erzeugt. Es gilt also, gezielt Praktiken einzusetzen, die der KI helfen, besseren Code zu generieren.
TDD als „Superpower“ im KI-Zeitalter
Kent Beck, der Begründer von Test-Driven Development und Extreme Programming, hat TDD im Kontext von KI neu bewertet. In seinem Podcast-Gespräch mit The Pragmatic Engineer (Juni 2025) beschreibt er TDD als regelrechte „Superpower“ für die Arbeit mit KI-generiertem Code. Tests dienen dabei als:
- Automatisches Erkennungssystem für Regressionen, die durch KI eingeführt werden.
- Spezifikationswerkzeug, das die menschliche Intention klar im Code ausdrückt.
- Qualitätskontrollmechanismus zur Verifikation des generierten Codes.
TDD adressiert dabei gezielt zwei der identifizierten Kernprobleme:
- Ein roter Test schafft Fokus. TDD erzwingt in kleinen oder zumindest konkreten Schritten vorzugehen. Anstatt der KI einen vagen Auftrag zu geben, definiert ein fehlschlagender Test exakt, was als Nächstes implementiert werden soll — und nichts anderes. Das grenzt den Scope ein und wirkt dem „Lost in the Middle“-Problem entgegen.
- Refactoring ermöglicht Human Judgment. Die Refactoring-Phase im TDD-Zyklus (Red -> Green -> Refactor) ist der natürliche Eingriffspunkt für menschliches Urteilsvermögen. Hier kann gegen typische Vibe-Coding-Antipatterns wie endlose If-Kaskaden oder redundanten Code gegengesteuert werden — ein klassischer Human-in-the-Loop-Moment.
Zusätzlich lässt sich die im TDD übliche Test-Liste bereits vor dem Coding mit der KI oder im Team überprüfen. So werden Lücken und Missverständnisse früh erkannt, bevor die erste Zeile Code generiert wird. Hierbei gilt – wie (fast) immer in der Softwareentwicklung: je früher ein Problem erkannt wird, desto geringer ist der Aufwand der Berichtigung.
Beispiele eliminieren Mehrdeutigkeiten
Besonders wirksam gegen das Problem der Mehrdeutigkeit natürlicher Sprache sind Methoden, die konkrete Beispiele in den Vordergrund stellen. Der Grund ist einfach:
- Regeln lassen Interpretationsspielraum
- Beispiele sind konkret
- Beispiele sind verifizierbar
Während eine Regel wie „Das System soll ungültige Eingaben ablehnen“ viel Raum für Interpretation lässt, zwingt ein konkretes Beispiel
Eingabe: -5 Erwartete Fehlermeldung: „Wert muss positiv sein“
zur Klärung. Diese Eindeutigkeit hilft nicht nur dem menschlichen Team, sondern gibt auch der KI eine präzise, überprüfbare Zielvorgabe.
Zu diesen beispielgetriebenen Ansätzen gehören:
- TDD (Test-Driven Development): Tests als ausführbare Spezifikation.
- BDD (Behaviour-Driven Development): Geschäftsverhalten in natürlicher Sprache mit konkreten Szenarien beschreiben.
- SBE (Specification by Example): Gojko Adzic beschreibt in seinem gleichnamigen Buch (2011, Jolt Award 2012), wie Teams durch konkrete Beispiele lebende Dokumentation schaffen.
- ATDD (Acceptance Test-Driven Development): Markus Gärtner liefert mit „ATDD by Example“ (Addison-Wesley, 2013) einen praktischen Einstieg.
- Example Mapping: Matt Wynne führte diese Technik 2015 ein, um in kurzen Workshops Akzeptanzkriterien durch Beispiele zu klären.
Diese Ansätze lassen sich unter dem Begriff „Example-Guided Development“ zusammenfassen, wie Matt Wynne in seinem Artikel auf cucumber.io beschreibt. Der gemeinsame Nenner: Konkrete Beispiele ersetzen vage Beschreibungen und geben der KI (und dem Menschen) eine klare, überprüfbare Zielvorgabe.
EXACT Coding: Der Workflow
Bevor es zum konkreten Workflow geht, eine Einordnung: Im Kern steht EXACT Coding für drei Prinzipien — schnelles Feedback, Verständnis vor Implementierung und konsequentes Shift Left. Der im Folgenden beschriebene Workflow ist nur eine konkrete Ausarbeitung dieser Prinzipien; weitere Ausprägungen werden bereits erprobt, sind aber noch nicht formalisiert.
Dieser Workflow war der erste, der sich in der Praxis bewährt hat — aus ihm haben sich die oben genannten Prinzipien erst herauskristallisiert.
EXACT Coding = EXample-guided AI-Collaborative Test-driven Coding
Das Akronym fasst das Vorgehen zusammen: Beispiele leiten den Prozess, die KI ist ein kollaborativer Partner (nicht autonomer Ersatz), und Tests treiben die Entwicklung. Im Folgenden wird dieser Workflow Schritt für Schritt erläutert.
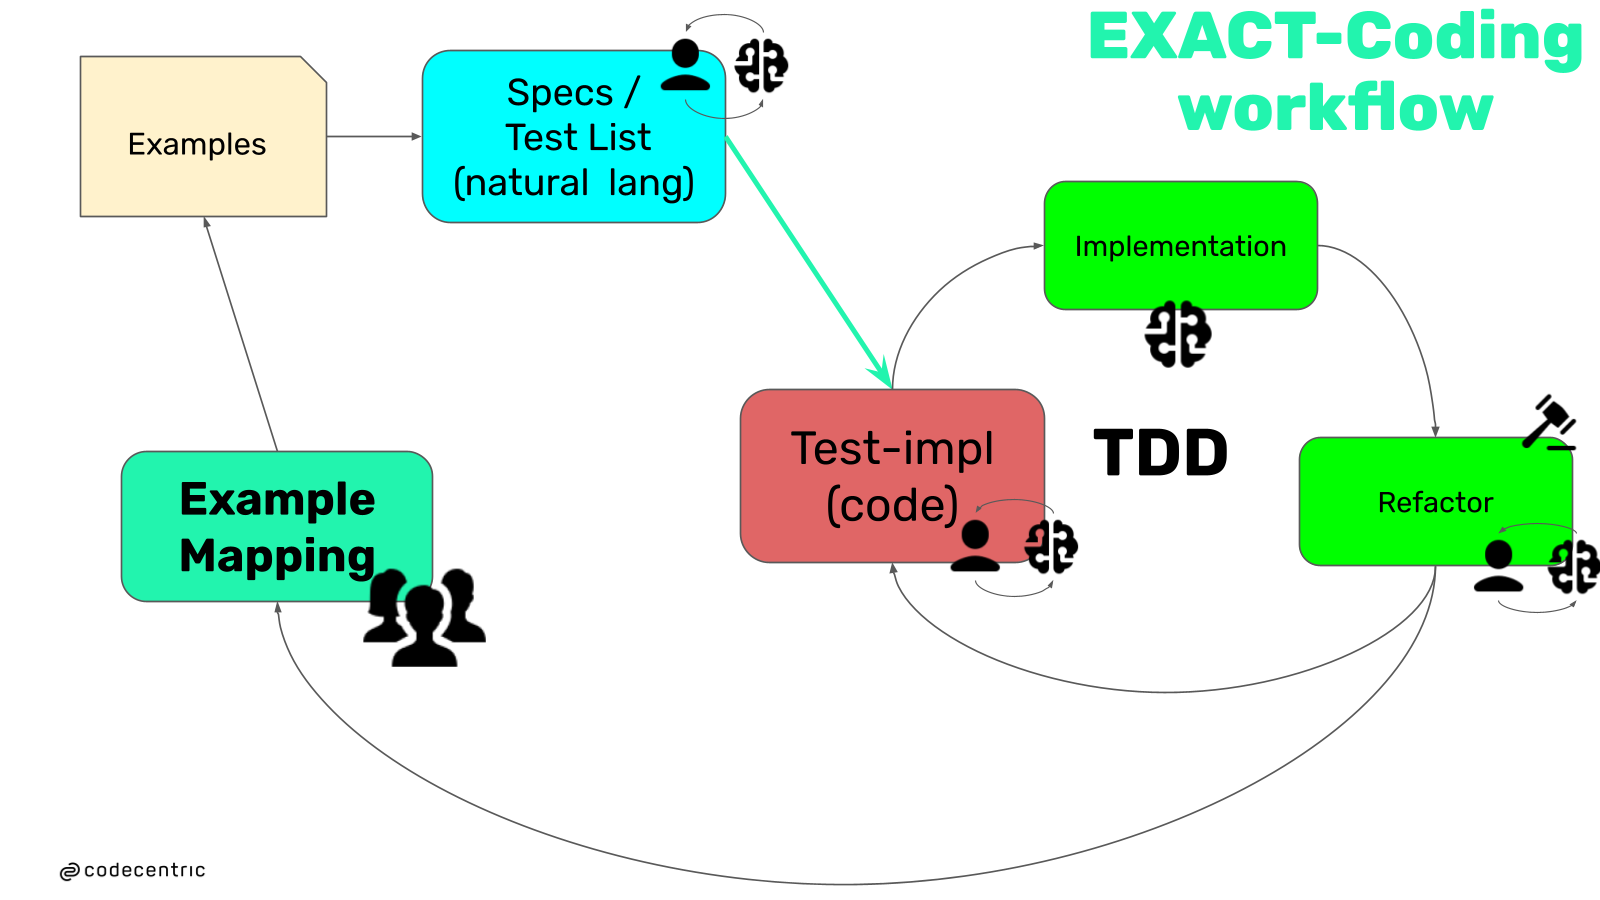
Schritt 1: Scope abstecken
Bevor es losgeht, muss der Scope klar abgesteckt werden. Typischerweise handelt es sich um ein neues Feature in einer existierenden Anwendung oder ein Konzept innerhalb eines Kernalgorithmus. Entscheidend ist: Das Feature muss klein genug sein, damit es den Kontext des LLM nicht zum Überlaufen bringt. Im Allgemeinen gilt: Je kleiner, desto besser.
Das bedeutet, dass ein sauberes Story-Slicing — wie es aus agilen Methoden bekannt ist — die Voraussetzung für EXACT Coding bildet. Techniken wie SPIDR helfen dabei, große User Stories in handhabbare, funktional geschnittene Scheiben zu zerlegen, die unabhängig voneinander einen (Business-)Wert liefern.
Schritt 2: Example Mapping durchführen
Der Prozess beginnt mit Example Mapping. Diese von Matt Wynne entwickelte Technik nutzt vier farbige Karten (oder digitale Entsprechungen), um in kurzen Workshops Akzeptanzkriterien zu klären:
- Gelb: Die User Story selbst.
- Blau: Regeln (Geschäftsregeln, Constraints).
- Grün: Konkrete Beispiele, die eine Regel illustrieren.
- Rot: Offene Fragen, die noch geklärt werden müssen.
Diese Aufgabe wird typischerweise im Team durchgeführt — zunächst ohne KI-Support. Für die Durchführung eignen sich grafische Kollaborationswerkzeuge wie Miro, FigJam oder Mural – oder auch einfach ein Tisch mit ein paar Sticky Notes.
(Eine detaillierte Einführung in Example Mapping würde den Rahmen dieses Buches sprengen. Matt Wynnes Originalartikel, die Cucumber-Dokumentation sowie die Bücher „Discovery: Explore behaviour using examples“ von Seb Rose und Gáspár Nagy und “DDD Toolbox” von Annegret Junker bieten einen guten Einstieg.)
Schritt 3: Test-Liste erstellen
Aus den Beispielen des Example Mappings wird nun eine Test-Liste abgeleitet. Dazu kann einfach ein Screenshot oder Export aus dem Kollaborationstool verwendet werden. Das LLM erstellt daraus eine strukturierte Liste von Testfällen.
An dieser Stelle greift bereits das erste Feedback-Instrument: Ein Mensch prüft die generierte Liste und kann Beispiele bzw. Tests hinzufügen, entfernen oder präzisieren. So wird sichergestellt, dass keine wichtigen Fälle übersehen wurden.
Die Test-Liste ist kein starres Dokument — sie wächst während der Entwicklung. Wie Kent Beck in seinem Canon TDD beschreibt, gehört das aktive Ergänzen neuer Tests zum Prozess: „adding items to the list as you discover them“. Immer wenn beim Implementieren oder Refactoring ein neuer Randfall oder eine Unklarheit auftaucht, wird er sofort als neuer Eintrag in der Liste festgehalten — und erst dann implementiert, wenn er an der Reihe ist. So bleibt der Fokus auf dem aktuellen Test erhalten.
Schritt 4: Rot-Phase — Test schreiben
Nun wechselt der Prozess in den TDD-Modus. Aus der Test-Liste wird ein Eintrag ausgewählt, und das LLM generiert aus der Testbeschreibung einen konkreten, fehlschlagenden Test (rot). Auch hier kontrolliert der Mensch, ob der Test zur Beschreibung passt.
Allerdings zeigt sich in der Praxis eine Schwierigkeit: Wird einem LLM TDD aufgetragen, folgt es dem Prozess oft nicht korrekt — obwohl es ihn auf Nachfrage problemlos beschreiben kann. Typische Fehler sind:
- Alte Tests werden auskommentiert.
- Produktionscode wird ohne roten Test generiert.
- Der Testcode passt nicht zur Testbeschreibung.
Um dem entgegenzuwirken, kann es helfen, mit Rule-Files, Commands, Skills oder Sub-Agents zu arbeiten. Dazu später mehr.
Schritt 5: Grün-Phase — Implementierung
In diesem Schritt macht das LLM den Test grün, indem es die minimale Implementierung generiert. Dies ist typischerweise der Teil, der am einfachsten und zuverlässigsten funktioniert — die KI spielt hier ihre Stärken aus.
Gerade weil TDD kleinschrittig vorgeht und jede einzelne Implementierung trivial wirkt, ist die Grün-Phase ideal für hohe KI-Autonomie: Das LLM kann diese Phase vollständig selbstständig durchführen, iteriert, wenn nötig und hält an, sobald alle Tests grün sind — ohne menschliches Eingreifen. Was für einen Menschen mühsam wäre (alle Fehlerdetails beachten, minimal genug bleiben), erledigt die KI schnell und zuverlässig. Die Trivialität der einzelnen Schritte ist gerade der Vorteil des Verfahrens: Sie macht diese Phase sicher automatisierbar. Die menschliche Expertise ist dagegen in der Refactoring-Phase gefragt, wo Designentscheidungen getroffen werden müssen.
Schritt 6: Refactoring
Nach dem Grün folgt das Refactoring. Auch hier können Rule-Files helfen, aber an dieser Stelle ist vor allem die Expertise des Menschen gefragt. Manchmal ist es sinnvoll, sich vom LLM verschiedene Refactoring-Möglichkeiten vorschlagen zu lassen und dann mit menschlicher Erfahrung die beste Option zu wählen.
Weitere Faktoren, die beim Refactoring eine Rolle spielen können:
- Qualitätskriterien: Performance, Stabilität, Sicherheit.
- Einschränkungen: Technologie-Stack, Plattform, bestehender Kontext.
- Architekturvorgaben: Konsistenz mit dem Gesamtsystem.
Schritt 7: Wiederholen
Danach wird der nächste Test aus der Liste genommen, und der Zyklus beginnt erneut mit der Rot-Phase. Dies wiederholt sich, bis alle Tests aus der Liste umgesetzt sind.
Autonomie-Stufen: Den Slider justieren
An dieser Stelle lohnt sich ein Rückgriff auf das Konzept des Autonomy-Sliders. Wie viel Autonomie das LLM im EXACT-Workflow erhält, ist einstellbar; je nach Einstellung ergeben sich unterschiedliche Trade-offs zwischen Produktivität und Kontrolle:
Stufe 1: Fast vollständige Autonomie
Das LLM führt den gesamten Prozess von der Test-Liste bis zur fertigen Implementierung eigenständig durch. Erst am Ende erfolgt ein menschlicher Review.
- Vorteile: Höchste Produktivität, minimaler menschlicher Aufwand während der Umsetzung.
- Nachteile: Geringste Sicherheit und Qualitätskontrolle.
-
Gefahren:
- Der Mensch versteht am Ende nicht mehr, was erzeugt wurde.
- Wenn früh eine falsche Richtung eingeschlagen wurde, ist eine Korrektur kaum noch möglich — ähnlich dem „Passt schon“-Abnicken bei klassischen Code-Reviews.
- Je größer die generierte Codemenge, desto gravierender diese Effekte.
Stufe 2: Halt nach jedem TDD-Zyklus
Nach jedem vollständigen Rot-Grün-Refactor-Zyklus hält der Prozess an. Der Mensch kann ins Refactoring eingreifen und im Dialog mit dem LLM den Code verbessern.
- Vorteile: Gute Balance zwischen Produktivität und Kontrolle. Fehler werden früh erkannt, bevor sie sich akkumulieren. Der Mensch behält das Verständnis für den Code.
- Nachteile: Etwas geringere Geschwindigkeit als bei vollständiger Autonomie.
Stufe 3: Halt nach jedem einzelnen Schritt
Nach jeder Phase (Rot, Grün, Refactor) erfolgt eine menschliche Prüfung.
- Vorteile: Maximale Kontrolle, sofortige Korrekturmöglichkeit bei Abweichungen.
- Nachteile: Geringste Produktivität, hoher menschlicher Aufwand.
Empfehlung: Unabhängig von der gewählten Stufe sollte der Prozess bei Ungereimtheiten sofort gestoppt werden — sei es ein Test, der nicht zur Beschreibung passt, oder eine Implementierung, die seltsam erscheint. Frühes Eingreifen ist immer günstiger als spätes Aufräumen.
Rule-Files und Konfiguration
Im vorherigen Abschnitt wurde erwähnt, dass Rule-Files, Commands, Skills oder SubAgents helfen können, das LLM auf dem TDD-Pfad zu halten. Dieser Abschnitt beleuchtet die verschiedenen Konfigurationsoptionen genauer.
Als Tools wurden primär Claude Code und Cursor erprobt. Andere Tools sind möglich, wurden aber nicht systematisch getestet. Ein Vorteil: Cursor kann die Claude-Konfiguration weitgehend kompatibel lesen, was einen Wechsel zwischen den Tools erleichtert.
Option 1: Rules-Files
Die einfachste Variante sind dedizierte Rules-Files, die im Projektverzeichnis abgelegt werden:
.cursor/rulesfür Cursor.claude/rulesoder eine zentraleCLAUDE.mdfür Claude Code
Die Rules werden beim Start in den Kontext geladen und geben dem LLM persistente Anweisungen — etwa „Schreibe immer zuerst einen fehlschlagenden Test“ oder „Kommentiere niemals bestehende Tests aus“.
- Vorteile: Einfach einzurichten, versionierbar und im Team teilbar. In Cursor lässt sich der Kontext visuell prüfen, in Claude Code via
/context. - Nachteile: Alles liegt im selben Kontext. Bei umfangreichen Rules kann das Kontextfenster schnell anwachsen — und Kontextgröße ist, wie beschrieben, ein Problem.
Option 2: Commands
Commands (in Claude Code auch „Slash Commands“) sind vordefinierte Befehle, die bei Bedarf aufgerufen werden. Cursor unterstützt ein kompatibles Format.
- Vorteile: Modularer als monolithische Rules-Files. Commands werden nur geladen, wenn sie gebraucht werden, was den Kontext entlastet.
- Nachteile: Erfordert manuelle Aufrufe oder explizite Anweisungen, wann welcher Command genutzt werden soll.
Option 3: SubAgents
SubAgents sind eigenständige Agenten, die in einem isolierten Kontext laufen und bei Bedarf vom Haupt-LLM angefordert werden. Statt des vollständigen Elternkontexts erhalten sie nur task-relevante Informationen basierend auf ihrer Konfiguration (siehe Claude Code Dokumentation).
-
Vorteile:
- Jeder SubAgent startet mit einem frischen Kontext — ideal für fokussierte Aufgaben.
- Verhindert „Kontextverschmutzung“ durch irrelevante Informationen aus vorherigen Schritten.
- Ermöglicht spezialisierte Agenten (z. B. ein „Refactoring-Agent“ mit eigenen Rules).
-
Nachteile:
- Der isolierte Kontext kann auch problematisch sein: Der SubAgent hat möglicherweise nicht alle Informationen, die er bräuchte.
- Höherer Konfigurationsaufwand.
- Debugging wird komplexer, da mehrere Kontexte involviert sind.
Option 4: Skills
Skills sind wiederverwendbare Workflows, die bei Bedarf in den Haupt-Kontext geladen werden. Sie nutzen Progressive Disclosure: Nur die Description ist initial sichtbar, der vollständige Inhalt wird bei Relevanz geladen.
-
Verzeichnisse:
.cursor/skills/für Cursor (nurSKILL.mdDateien).claude/skills/für Claude Code (SKILL.md+ optional Package mit Templates, Scripts, Examples)
-
Vorteile:
- Modular wie Commands, aber mit Progressive Disclosure — spart Kontext-Tokens.
- Können von SubAgents vor-geladen werden (via
skills:Feld in der Agent-Konfiguration). - Package-Format ermöglicht zusätzliche Ressourcen wie Templates oder Scripts (Claude Code).
- Automatische Nutzung bei Relevanz möglich, basierend auf der Description.
-
Nachteile:
- Ähnlich wie Commands: erfordert klare Beschreibungen (Descriptions) für automatische Nutzung.
- Package-Format nur bei Claude Code verfügbar, nicht bei Cursor.
Abgrenzung zu anderen Optionen:
- vs. Rules: Skills werden nur bei Bedarf geladen, nicht beim Start — entlasten den initialen Kontext.
- vs. Commands: Skills nutzen Progressive Disclosure (Description -> vollständiger Inhalt) und können Packages sein.
- vs. SubAgents: Skills laufen im Haupt-Kontextfenster, nicht isoliert — haben vollen Zugriff auf Parent-Kontext.
Praxisbeispiele
Konkrete Beispiele für solche Optionen finden sich im begleitenden Repository EXACT-Coding-Exercises auf GitHub. Die Struktur spiegelt die verschiedenen Ansätze wider:
- Rules (
rules/): Allgemeine TDD-Anweisungen, z. B.tdd.mdfür die Grundregeln oderhuman-in-the-loop.mdfür explizite Stopppunkte. - Commands (
commands/): Modulare Befehle für die einzelnen TDD-Phasen —red.md,green.md,refactor.mdsowietest-list.mdfür die initiale Testerstellung. - Agents (
agents/): Spezialisierte SubAgents für dieselben Phasen, die in isolierten Kontexten arbeiten. Zusätzlich eincode-improvement-scanner.mdfür automatisierte Qualitätsprüfungen. - Skills: Werden typischerweise projektübergreifend in
~/.cursor/skills/oder~/.claude/skills/gespeichert. Beispiele finden sich in den Standard-Skill-Bibliotheken beider Tools.
Diese Beispiele dienen als Ausgangspunkt und können an die eigenen Bedürfnisse angepasst werden. Die Dateien sind unter MIT-Lizenz frei verfügbar.
Empfehlung: Für den Einstieg reichen einfache Rules-Files. Sobald der Kontext zu groß wird oder spezialisierte Aufgaben (wie Refactoring) konsistent scheitern, lohnt sich der Umstieg auf Commands, Skills oder SubAgents. Skills bieten dabei einen guten Mittelweg zwischen Commands (modular) und SubAgents (isoliert) — sie bleiben im Haupt-Kontext, nutzen aber Progressive Disclosure für bessere Kontext-Effizienz.
Übersicht der Instruktionsdateien
Die EXACT-Instruktionen verteilen sich auf drei Verzeichnisse innerhalb von .claude/:
rules/— Regeln, die immer im Kontext aktiv sindagents/— Spezialisierte SubAgents für jede TDD-Phasecommands/— Slash-Commands, die der Nutzer manuell auslöst
| Datei | Zweck | Typ |
|---|---|---|
rules/tdd.md |
Haupt-TDD-Regeln | Rule (immer aktiv) |
rules/human-in-the-loop.md |
Checkpoint-Regeln | Rule (immer aktiv) |
rules/tdd_with_ts_and_vitest.md |
Stack-spezifische Regeln | Rule (immer aktiv) |
agents/test-list.md |
Erstellt Test-Liste | SubAgent |
agents/red.md |
Aktiviert nächsten Test | SubAgent |
agents/green.md |
Minimale Implementierung | SubAgent |
agents/refactor.md |
Refactoring | SubAgent |
commands/test-list.md |
Startet Test-List-Phase | Slash-Command |
commands/red.md |
Startet Red-Phase | Slash-Command |
commands/green.md |
Startet Green-Phase | Slash-Command |
commands/refactor.md |
Startet Refactor-Phase | Slash-Command |
Die Rules sind immer aktiv und bilden das Fundament. Die Commands dienen als Einstiegspunkte, die der Nutzer per /test-list, /red, /green oder /refactor aufruft. Jeder Command delegiert die eigentliche Arbeit an den passenden SubAgent, der in einem eigenen Kontext läuft.
Rules
rules/tdd.md — Die TDD-Grundregeln
Diese Datei definiert den gesamten TDD-Workflow und erzwingt die Nutzung spezialisierter Agents für jede Phase (test-list, red, green, refactor). Wichtige Inhalte:
- Phasen-Disziplin: Das LLM darf Code niemals direkt schreiben; es muss den passenden Agent für die jeweilige Phase starten.
- Refactoring als eigene Phase: Refactoring erfordert immer einen separaten Agent-Aufruf — es darf niemals mit der Green-Phase kombiniert werden.
- Failure Modes: Listet typische Fehler auf — etwa „mehrere Tests gleichzeitig aktiv“, „Implementierung ohne roten Test“ oder „Refactoring überspringen“.
rules/human-in-the-loop.md — Die Checkpoint-Regeln
Diese Datei sorgt dafür, dass der Mensch die Kontrolle behält:
- End-of-Phase Confirmation: Nach jeder Phase (Rot, Grün, Refactor) muss das LLM stoppen, zusammenfassen und explizit um Erlaubnis fragen, bevor es fortfährt.
- Failed Prediction Recovery: Wenn eine Vorhersage im „Guessing Game“ (Was wird der Test ausgeben?) fehlschlägt, stoppt der Prozess sofort — ein Zeichen für ein Missverständnis, das geklärt werden muss.
- Kernprinzip: „Never Proceed Without Permission“ — keine Phase ohne explizite Freigabe.
rules/tdd_with_ts_and_vitest.md — Stack-spezifische Regeln
Diese Datei enthält technische Details für TypeScript und Vitest (Testausführung, Import-Konventionen etc.). Wichtig: Diese Datei sollte durch ein passendes Äquivalent für den eigenen Technologie-Stack ersetzt werden.
Agents und Commands
Die SubAgents (agents/) kapseln die Logik der einzelnen TDD-Phasen. Jeder Agent läuft in einem eigenen Kontext und kennt nur die für seine Phase relevanten Regeln. So kann der red-Agent z. B. genau einen Test aktivieren und verifizieren, dass er fehlschlägt — ohne Versuchung, gleich die Implementierung mitzuliefern.
Die Commands (commands/) sind die Brücke zwischen Mensch und Agent: /red startet den Red-Agent, /refactor den Refactor-Agent.
Ein praktisches Beispiel
Um den EXACT-Workflow in Aktion zu zeigen, bietet sich ein konkretes Beispiel an. Bei der Wahl des Beispiels ist ein Aspekt entscheidend: Die Lösung sollte nicht bereits vollständig in den Trainingsdaten des LLM enthalten sein. Klassische Coding-Katas wie FizzBuzz, Roman Numerals oder die String Calculator Kata wurden millionenfach im Internet publiziert — ein LLM würde hier einfach eine memorierte Lösung reproduzieren, anstatt den TDD-Prozess tatsächlich zu durchlaufen.
Als Beispiel dient Overlords: The Card Game — ein reales Kartenspiel, das so unbekannt ist, dass es mit hoher Wahrscheinlichkeit nicht in den Trainingsdaten des LLM vorkommt. Das Spiel ist offiziell verfügbar auf BoardGameGeek und The Game Crafter.
Die Spielidee
Bei Overlords: The Card Game geht es darum, am Ende des Spiels einen Stapel von Karten zu besitzen. Jede Karte repräsentiert eine mythologische Kreatur, und jede dieser Kreaturen hat ihr eigenes Set an Regeln, wie die Punkte gewertet werden.
Die erste Karte: Chimera
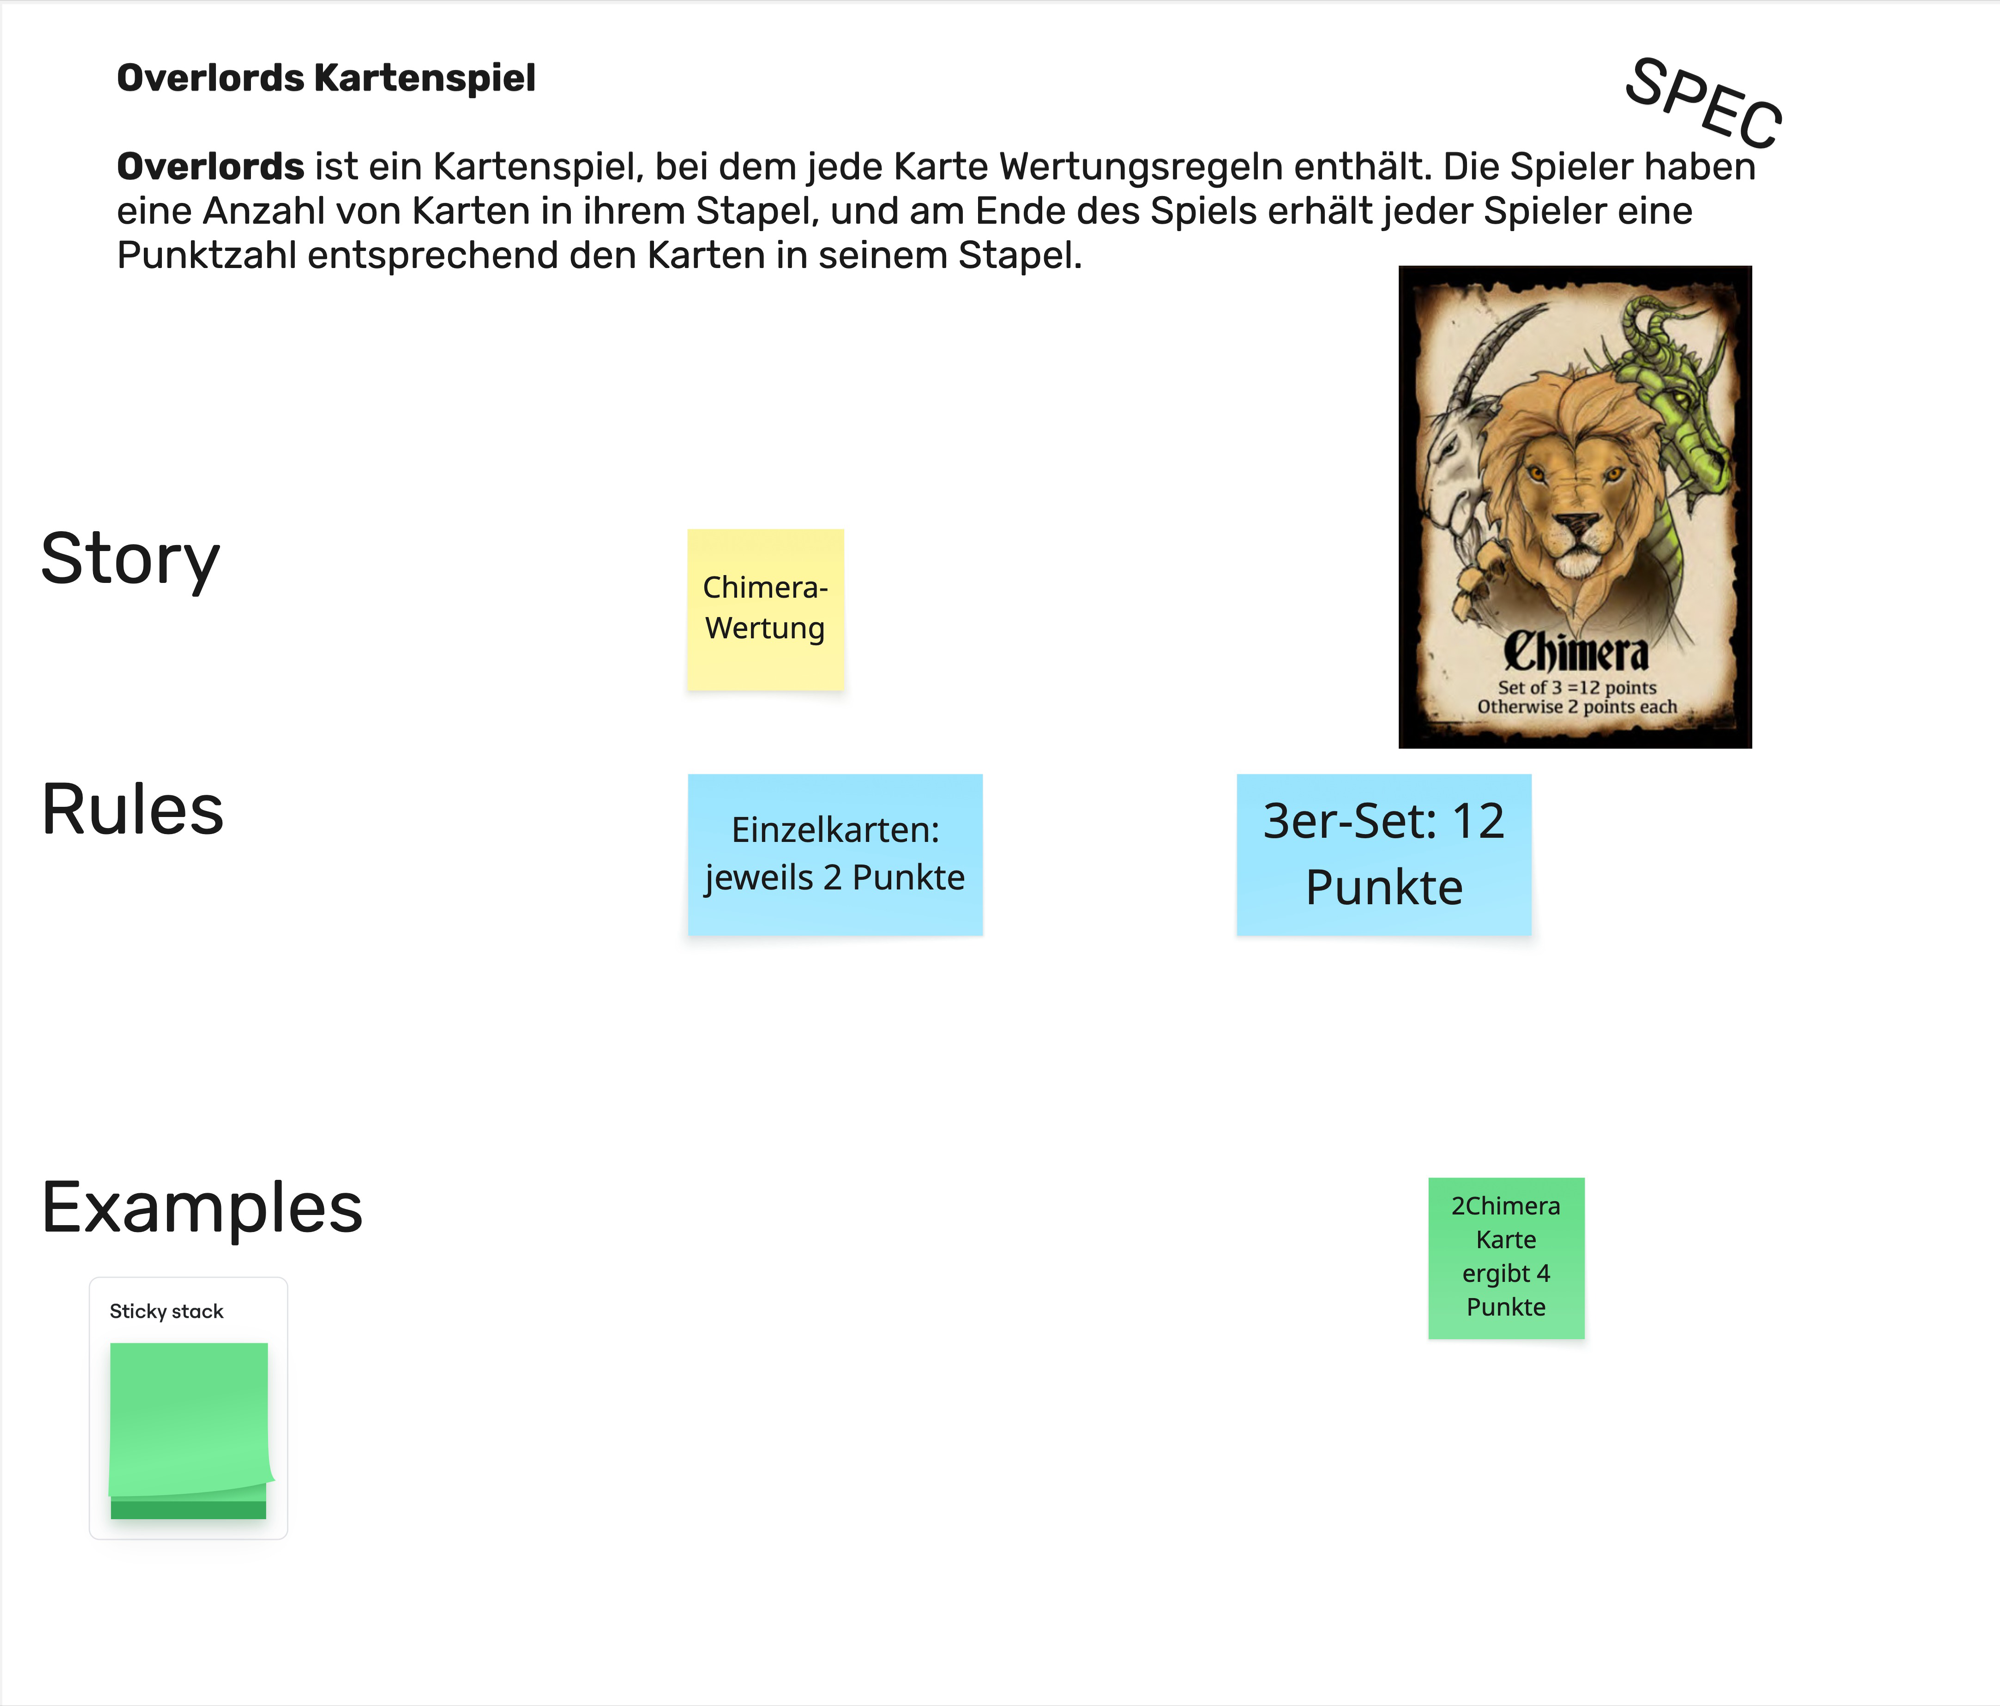
Die erste Karte, die implementiert werden soll, ist Chimera — in der griechischen Mythologie die Chimäre, ein feuerspeiendes Mischwesen (Löwenkörper, Ziegenkopf, Schlangenschwanz). Auf der Karte steht:
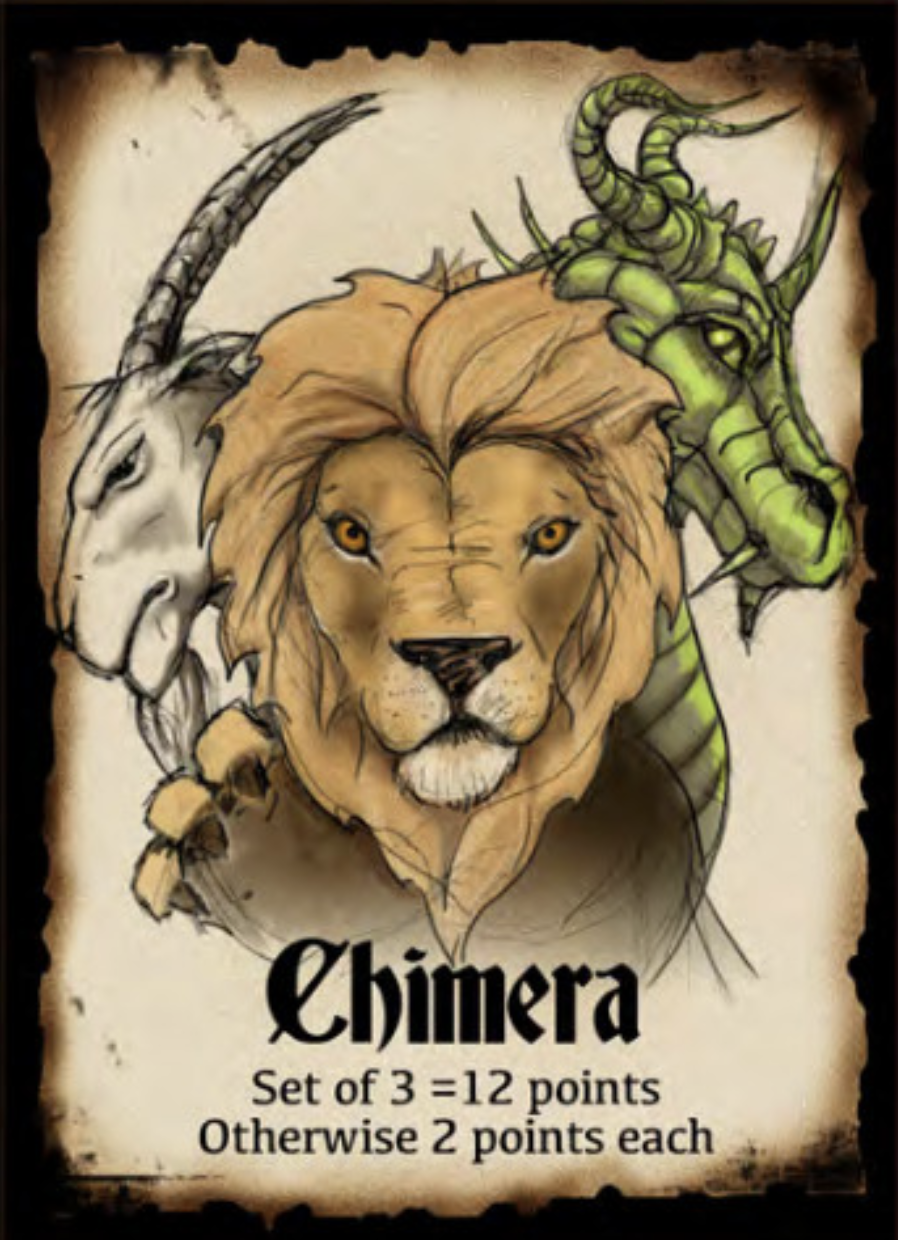
Das bedeutet: 3 Chimera-Karten am Spielende ergeben 12 Punkte. In allen anderen Fällen gibt es 2 Punkte pro Chimera-Karte.
Auf den ersten Blick trivial
Set of 3 = 12 points, Otherwise 2 points each. Zwei Zeilen, zwei klare Regeln. Zunächst scheint es, als gäbe es nichts zu klären und als stünde der Implementierung nichts mehr im Wege. Doch diese Sicherheit trügt.
Warum Example Mapping trotzdem lohnt
Vor der ersten Codezeile steht bewusst ein Example Mapping. Die Gründe:
- Regeln werden missverstanden. Jeder im Team liest dieselbe Regel — und interpretiert sie anders. Das fällt oft erst auf, wenn zwei Entwickler unterschiedlichen Code schreiben.
- Edge Cases fallen erst bei konkreten Beispielen auf. Abstrakte Regeln klingen vollständig. Erst beim Einsetzen konkreter Zahlen tauchen die Fragen auf: Was passiert bei 4 Karten? Bei 0 Karten?
- Shift Left. Missverständnisse, die beim Coden auffallen, kosten ein Vielfaches. Example Mapping zieht diese Klärung nach vorne — in einen 15-Minuten-Workshop statt in einen Nachmittag Debugging.
- Mentales Modell aufbauen. Wer sich nicht selbst mit den Regeln auseinandergesetzt hat, kann Fehler darin nicht erkennen — egal ob sie von einem Kollegen kommen oder von einem LLM. Example Mapping erzwingt diese Auseinandersetzung und baut ein mentales Modell auf, bevor der erste Code entsteht.
Schritt für Schritt: Das Example Mapping aufbauen
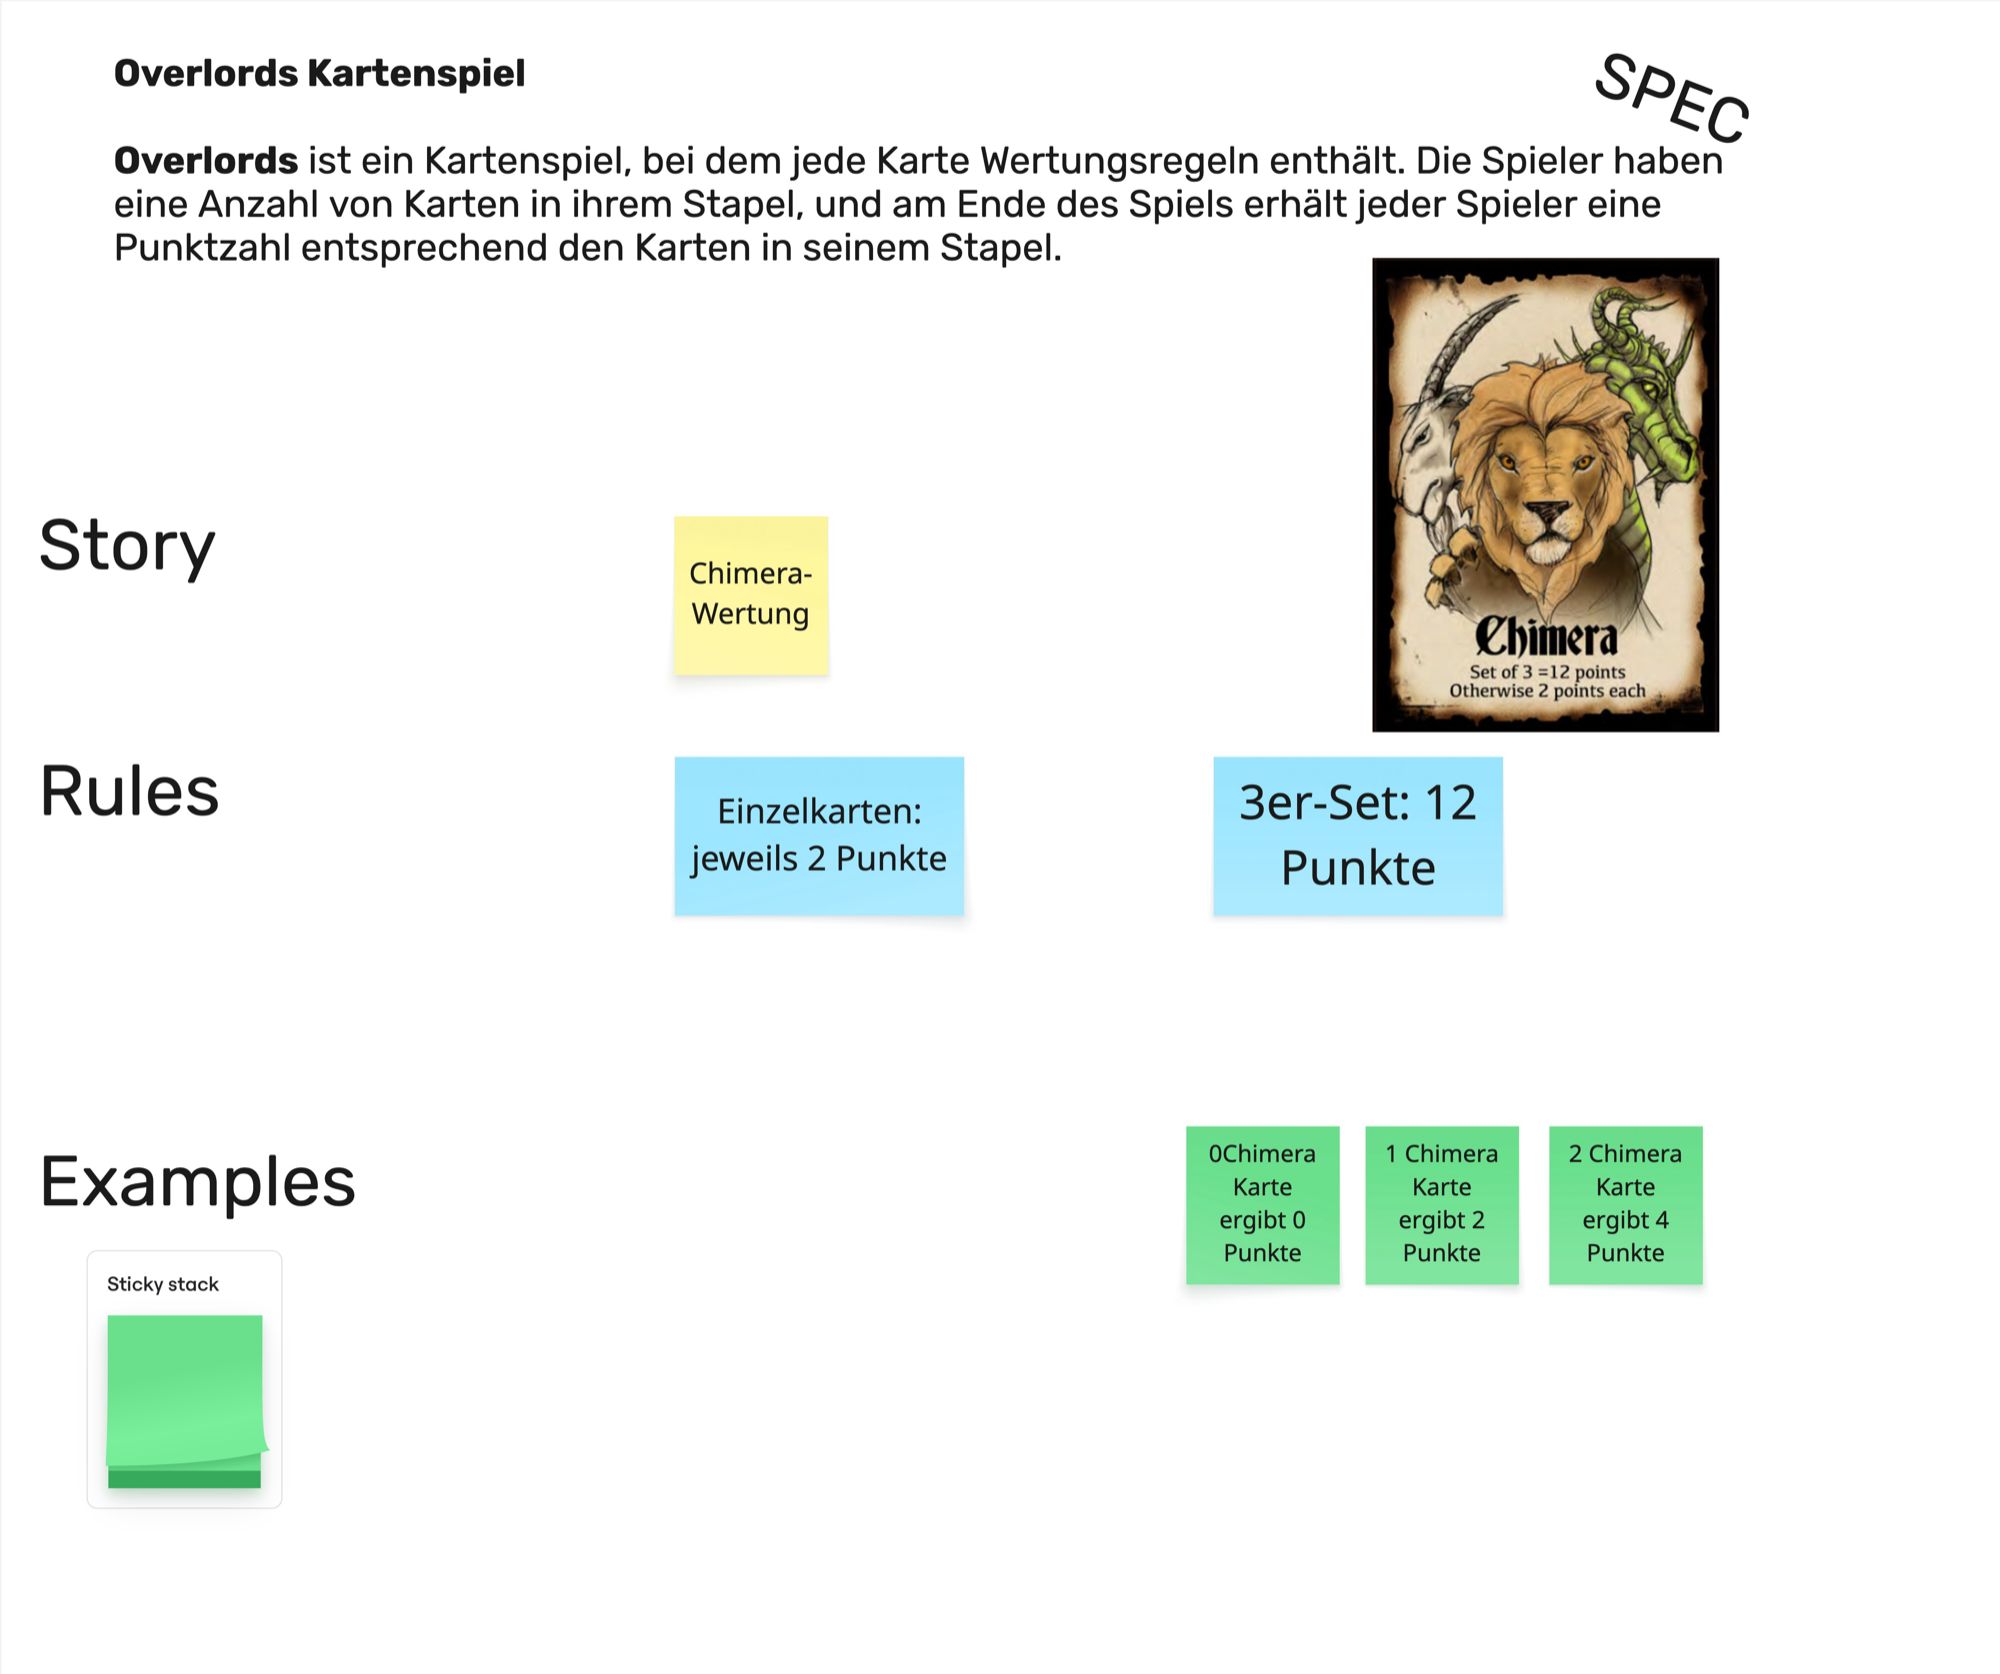
Den Einstieg bildet die Story-Karte (gelb): „Chimera-Wertung“. Dazu werden die beiden Regeln (blau) angelegt: „Einzelkarten: jeweils 2 Punkte“ und „3er-Set: 12 Punkte“.
Zuerst die einfachere Regel. Ein erstes konkretes Beispiel (grün) lautet: 2 Karten -> 4 Punkte.
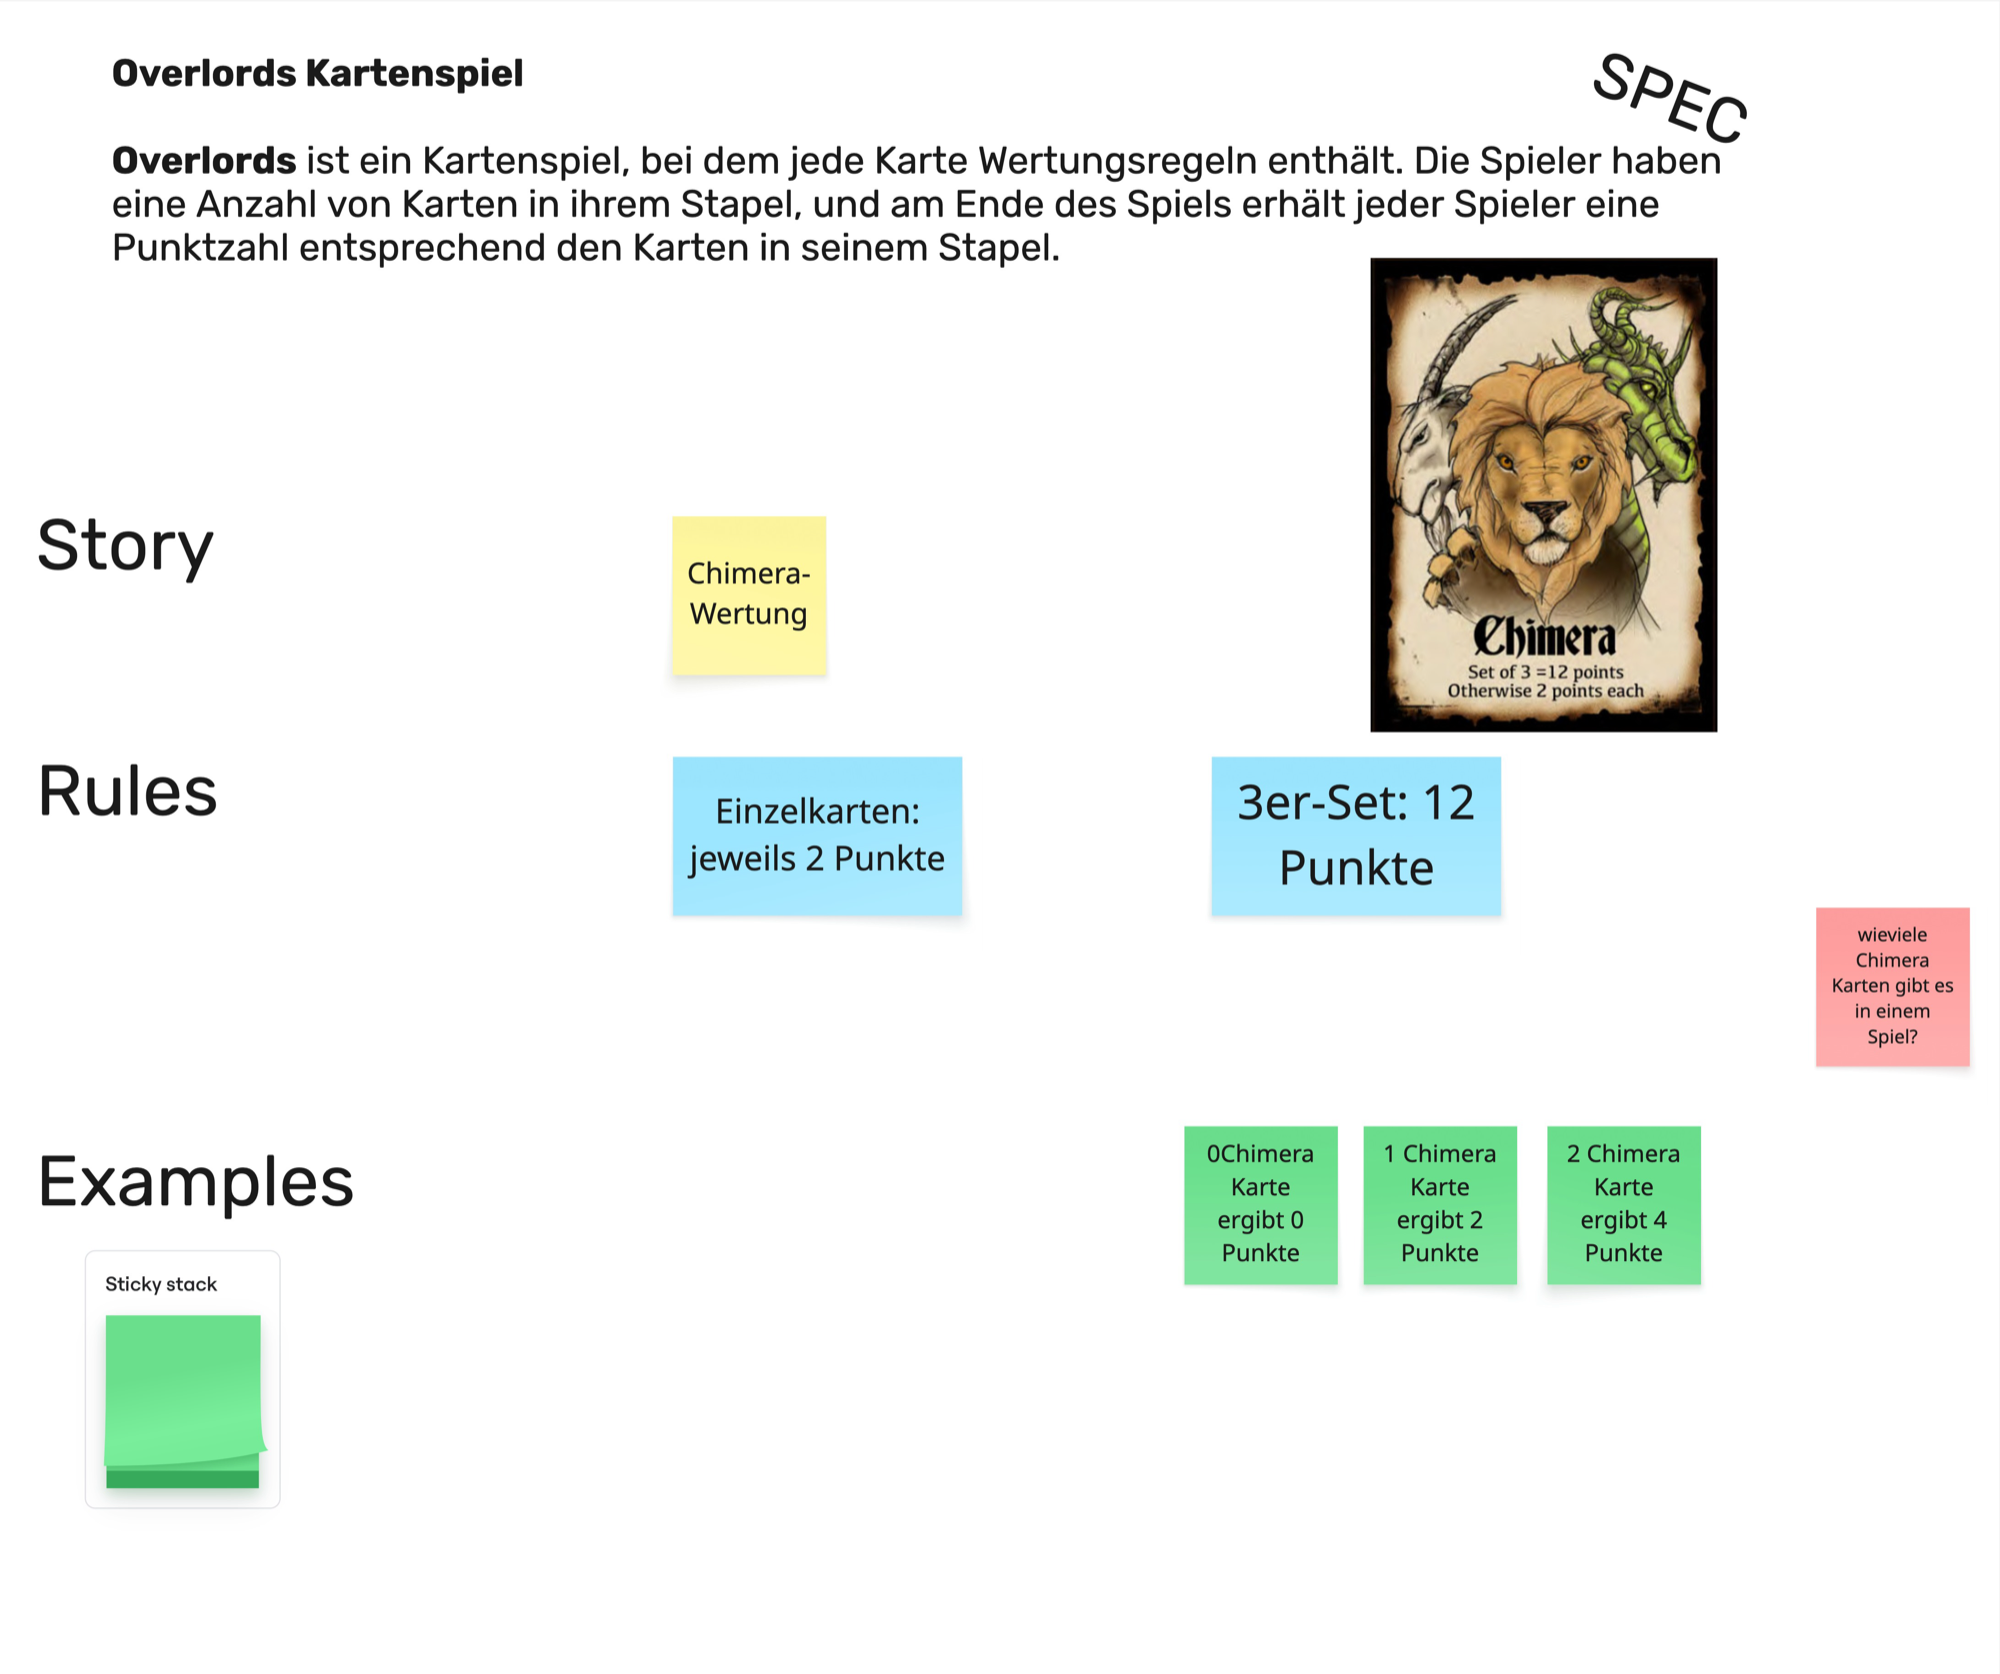
Weitere Beispiele folgen schnell: 0 Karten -> 0 Punkte, 1 Karte -> 2 Punkte. Damit ist die Einzelkarten-Regel gut abgedeckt.
Nun folgt die Set-Regel. Doch bevor das erste Set-Beispiel entsteht, kommt eine Frage auf: Wie viele Chimera-Karten gibt es eigentlich im Spiel? Niemand im Raum kann das spontan beantworten. Genau für solche Situationen existieren die roten Karten: offene Fragen, die später geklärt werden müssen. Die Frage wird notiert, der Workshop läuft weiter.
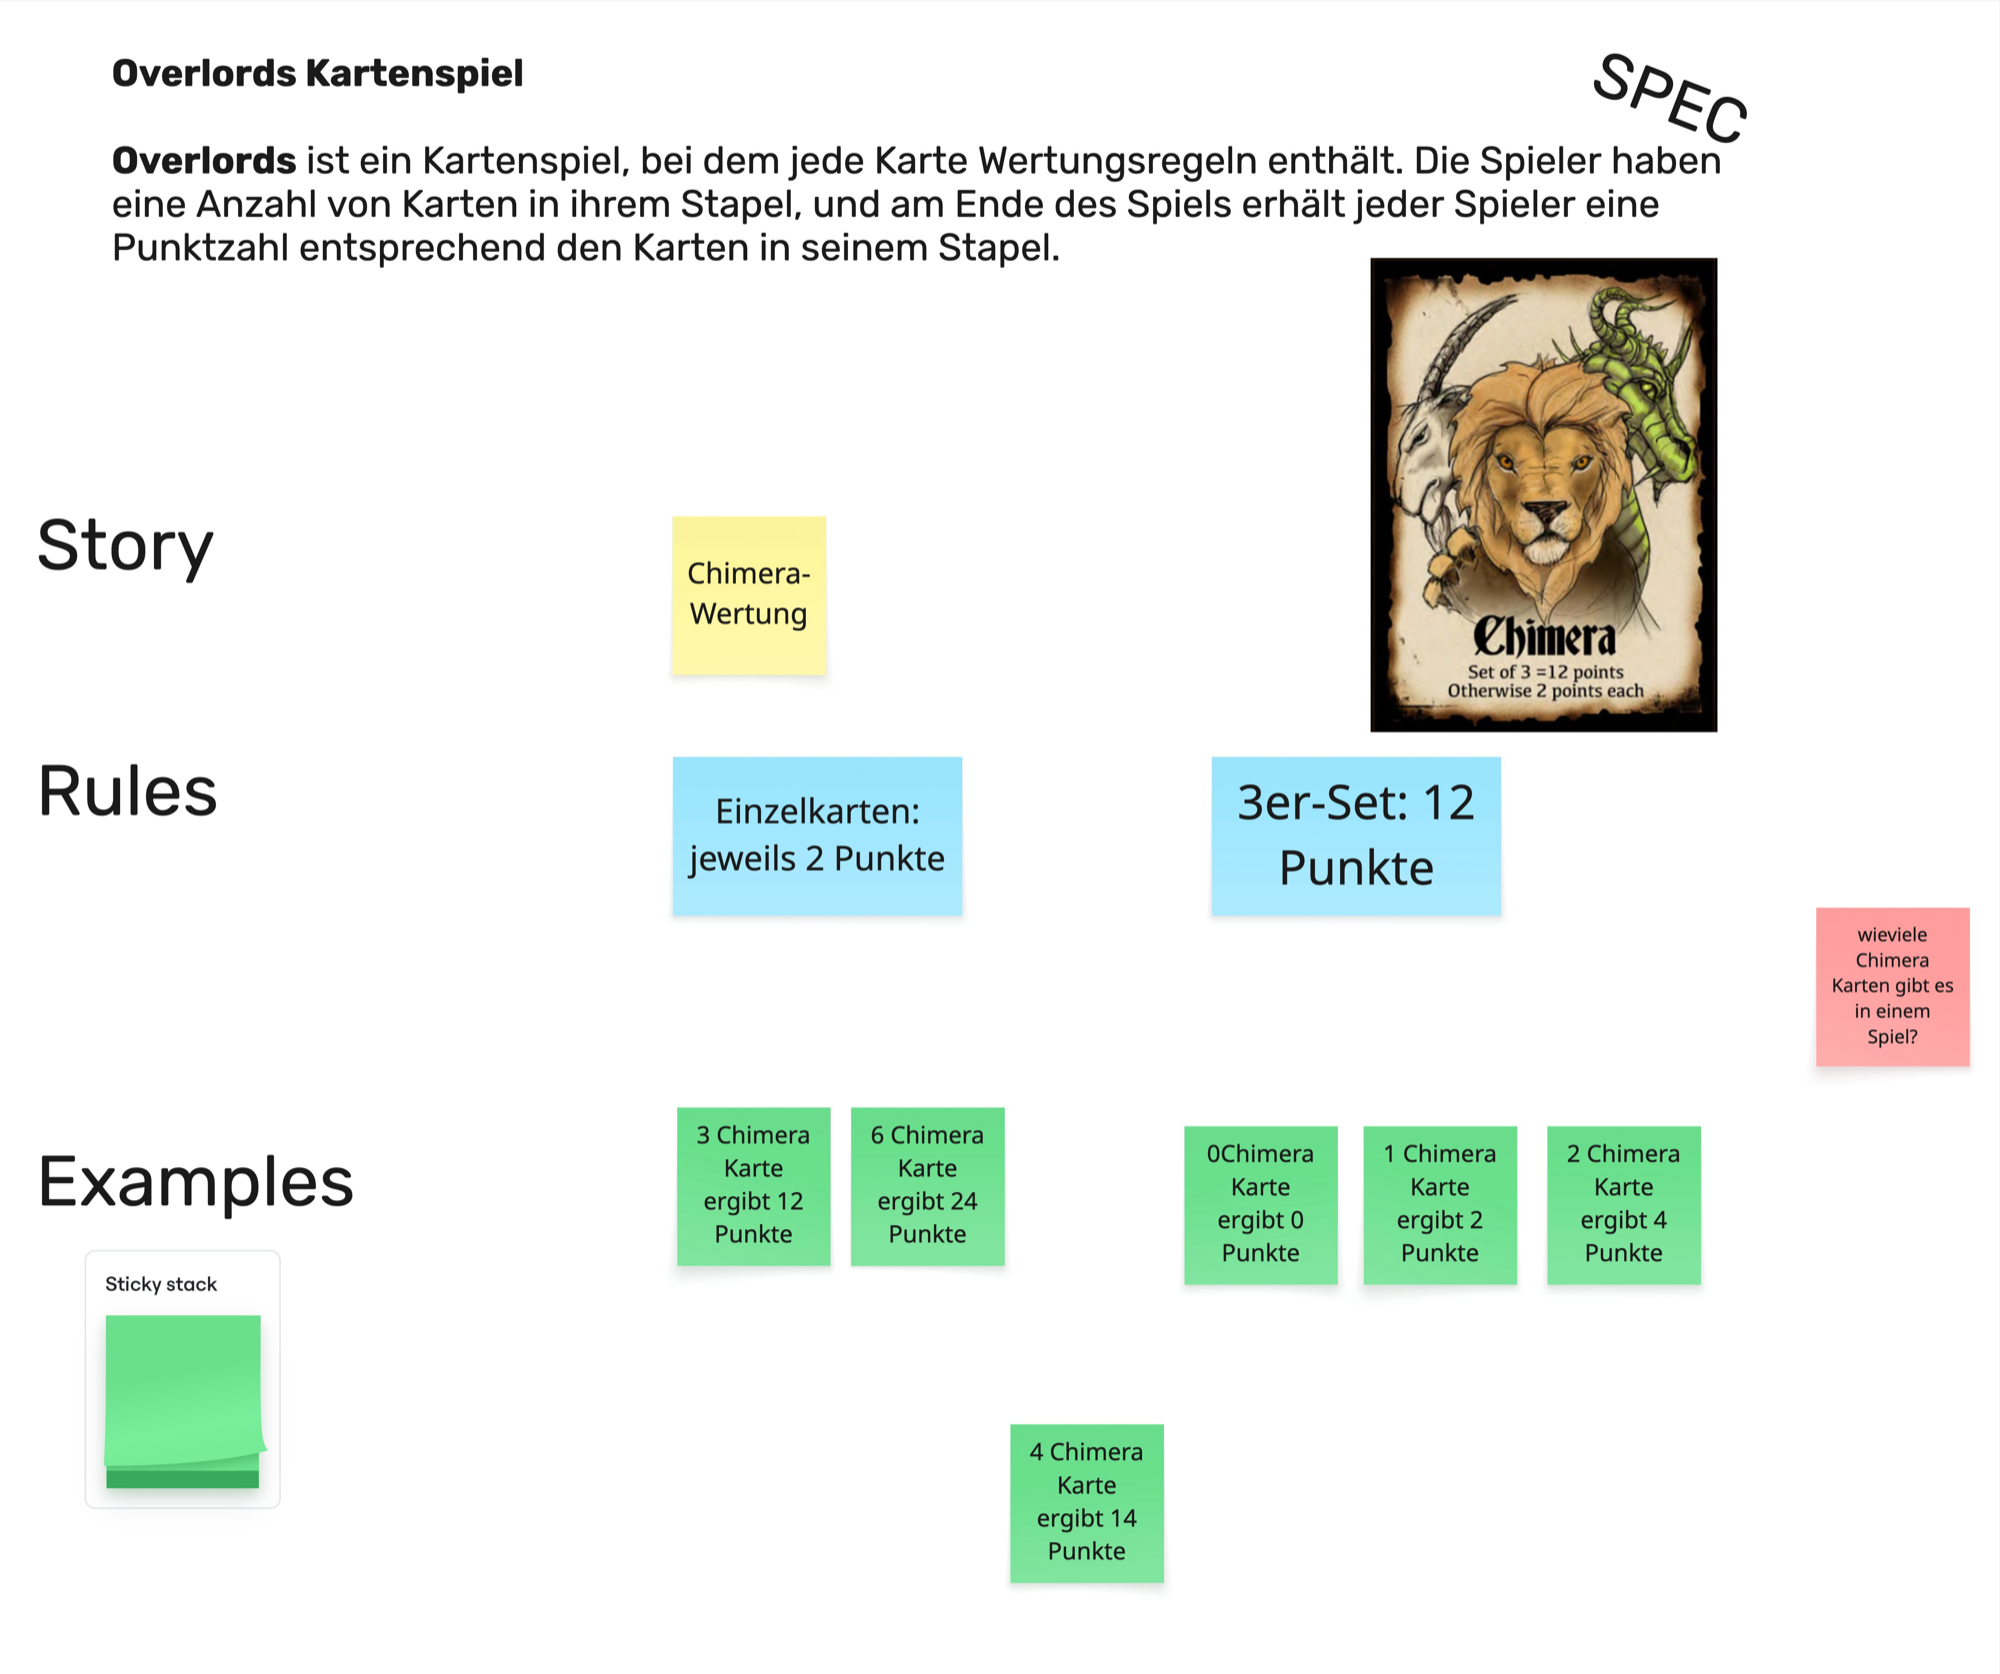
Weiter geht’s mit der Set-Regel. 3 Karten -> 12 Punkte — ein vollständiges Set, das ist klar.
Aber wie sieht es bei 6 Karten aus? Sind das 2 Sets für 24 Punkte — oder zählt nur 1 Set, und die restlichen 3 Karten werden einzeln gewertet? Aus der Regel allein lässt sich das nicht eindeutig ableiten. Der Spieleexperte im Raum bestätigt: 6 Karten ergeben 24 Punkte. Mehrere Sets sind möglich.
Damit zeigt sich ein weiterer Fall: Was passiert bei 4 Karten? Bilden 3 davon ein Set, und die vierte zählt als Einzelkarte — also 14 Punkte? Oder greift die Set-Regel gar nicht, weil es kein vollständiges zweites Set gibt, und alle 4 Karten werden einzeln gewertet — also 8 Punkte?
Auch hier ist die Antwort: Ein Set wird immer gebildet, sobald drei Karten vorhanden sind. 4 Karten -> 14 Punkte.
Rückblick: Doch nicht so trivial
Zwei Zeilen auf einer Spielkarte — und trotzdem waren mehrere Interpretationen möglich. Ohne diese Klärung hätte jeder im Team — und jedes LLM — etwas anderes implementiert. Und das war ein einfaches Kartenspiel. In echten Projekten sind die Regeln selten so übersichtlich.
Vom Kartenspiel zum Alltag
In vielen Softwareprojekten — insbesondere dort, wo Business-Software entsteht — steckt das Domänenwissen in den Köpfen der Fachleute: verteilt, implizit, oft widersprüchlich. Methoden wie Example Mapping holen dieses Wissen heraus: gemeinsam, in 15 Minuten, mit direktem Feedback. Das gemeinsam ist dabei entscheidend: Die analytische Denkweise und der frische Blick der Entwickler treffen auf das Erfahrungswissen der Fachleute, denen oft nicht mehr bewusst ist, welche Missverständnisse möglich sind. Diese Kombination deckt Lücken auf, die keiner der beiden Seiten allein auffallen würde — und stellt sicher, dass die Entwickler wirklich verstanden haben, was sie bauen sollen. Statt dass ein Entwickler allein eine Anforderung interpretiert und der Fehler erst beim Code-Review, bei der fachlichen Abnahme oder im schlimmsten Fall auf Produktion auffällt, werden Missverständnisse direkt geklärt — bevor die erste Zeile Code entsteht.
LLM als Sparringspartner
Abschließender Hinweis: Es lohnt sich, die fertigen Beispiele am Ende von einem LLM gegenlesen zu lassen. Oft fällt dem LLM noch ein Fall ein, den niemand im Raum bedacht hat. Wichtig ist dabei die Reihenfolge: Zuerst soll das Team allein denken, um den Flow nicht zu stören — erst danach dient das LLM als zusätzliche Prüfung.
Die TDD-Session im Dialog
Die folgende Session zeigt den EXACT-Workflow in Aktion. Das LLM (hier: Cursor mit einem TDD-Skill) führt den TDD-Prozess durch, während der Mensch an definierten Checkpoints eingreift. Die Prompts sind bewusst minimal gehalten — der TDD-Skill steuert den Ablauf.
Mensch: [Übergibt Screenshot des Example Mappings] Wir starten eine TDD-Session. Erstelle zunächst eine Testumgebung für TypeScript mit Vitest.
LLM: [Erstellt package.json, tsconfig.json und eine erste Testdatei. Erkennt aus dem Example Mapping die Testfälle.]
Aus dem Example Mapping haben wir folgende Testfälle:
- 0 Karten -> 0 Punkte
- 1 Karte -> 2 Punkte
- 2 Karten -> 4 Punkte
- 3 Karten -> 12 Punkte (1 Set)
- 4 Karten -> 14 Punkte (1 Set + 1 Karte)
- 6 Karten -> 24 Punkte (2 Sets)
Bereit für TDD! Mit welchem Beispiel soll begonnen werden?
Mensch: Wenn du den TDD-Skill verwendest, mit was solltest du anfangen?
LLM: Laut dem TDD-Skill sollte mit Schritt 1: Test List First begonnen werden — also it.todo() Einträge für die Basis-Funktionalität erstellen:
1 describe("Chimera Scoring", () => {
2   it.todo("should score 0 points for 0 cards");
3   it.todo("should score 2 points for 1 card");
4   it.todo("should score 4 points for 2 cards");
5   it.todo("should score 12 points for 3 cards (1 set)");
6   it.todo("should score 14 points for 4 cards (1 set + 1 card)");
7   it.todo("should score 24 points for 6 cards (2 sets)");
8 });
Soll ich die Test-Liste erstellen?
Mensch: ja
LLM: [Erstellt die Test-Liste, führt Tests aus]
1 ↓ src/Chimera.spec.ts (6 tests | 6 skipped)
2   ○ should score 0 points for 0 cards
3   ○ should score 2 points for 1 card
4   ○ should score 4 points for 2 cards
5   ○ should score 12 points for 3 cards (1 set)
6   ○ should score 14 points for 4 cards (1 set + 1 card)
7   ○ should score 24 points for 6 cards (2 sets)
Nächster Schritt: Genau EINEN it.todo() in einen ausführbaren Test umwandeln. Der einfachste Fall wäre “0 cards -> 0 points”. Soll ich diesen Test aktivieren?
Mensch: j
LLM: [Aktiviert den Test, macht eine Vorhersage („Guessing Game“), führt ihn aus]
Prediction: ReferenceError, “scoreChimeraCards is not defined”
1 🔴 Red Phase Complete:
2 - Test aktiviert: "should score 0 points for 0 cards"
3 - Prediction: ReferenceError ✅
4 - Result: ReferenceError: scoreChimeraCards is not defined
5
6 Red phase complete. Should I proceed to Green phase?
Mensch: j
LLM: [Implementiert die minimale Lösung]
1 export function scoreChimeraCards(cardCount: number): number {
2   return 0;
3 }
1 🟢 Green Phase Complete:
2 - Implementation: Hardcoded return 0
3 - Result: All tests pass (1 passed, 5 todo)
4
5 Green phase complete. Should I proceed to Refactor phase?
Mensch: j
LLM: [Analysiert den Code für Refactoring]
Simple Design Check:
- ✅ Tests Pass
- ✅ Reveals Intent —
scoreChimeraCards,cardCountsind klar - ✅ No Duplication
- ✅ Fewest Elements — minimal
1 🔄 Refactor Phase Complete:
2 - Naming: kept as-is
3 - Structure: none needed
4
5 Refactor phase complete. Should I proceed to next test?
Mensch: Nein. cardCount ist mir als Variablenname nicht genau genug. Ich hätte gerne numberOfCards. Lege für Points außerdem einen Type Alias auf Number an.
LLM: [Führt die gewünschten Refactorings durch, verifiziert, dass Tests weiterhin grün sind]
1 type Points = number;
2
3 export function scoreChimeraCards(numberOfCards: number): Points {
4   return 0;
5 }
1 🔄 Refactor Phase Complete:
2 - Naming: angepasst nach Wunsch
3 - Types: Added type alias Points = number
4
5 Refactor phase complete. Should I proceed to next test?
Mensch: j
Die Session setzt sich fort. Bei jedem Zyklus fragt das LLM nach Bestätigung, macht Vorhersagen und stoppt für menschliches Feedback. Besonders interessant wird der dritte Zyklus (3 Karten -> 12 Punkte), bei dem die Set-Logik implementiert werden muss:
LLM: [Nach der Green Phase für den Set-Test]
Aktueller Code:
1 export function scoreChimeraCards(numberOfCards: number): Points {
2   const sets = Math.floor(numberOfCards / 3);
3   const remaining = numberOfCards % 3;
4   return sets * 12 + remaining * 2;
5 }
1 🔄 Refactor Phase:
2 - Naming: sets, remaining sind klar
3 - Magic Numbers: 3, 12, 2 könnten zu Konstanten werden
4 - Structure: Logik ist lesbar
5
6 Weiterer Input?
Mensch: Welche Refactorings schlägst du vor?
LLM: Die Magic Numbers könnten zu Konstanten extrahiert werden:
| Magic Number | Mögliche Konstante |
|---|---|
3 |
CARDS_PER_SET |
12 |
POINTS_PER_SET |
2 |
POINTS_PER_CARD |
Mensch: Führe die Refactorings durch.
LLM: [Extrahiert die Konstanten]
1 const CARDS_PER_SET = 3;
2 const POINTS_PER_SET = 12;
3 const POINTS_PER_CARD = 2;
4
5 export function scoreChimeraCards(numberOfCards: number): Points {
6   const sets = Math.floor(numberOfCards / CARDS_PER_SET);
7   const remaining = numberOfCards % CARDS_PER_SET;
8   return sets * POINTS_PER_SET + remaining * POINTS_PER_CARD;
9 }
Die verbleibenden Tests (4 Karten, 6 Karten) bestehen sofort ohne weitere Code-Änderungen — die Implementierung ist bereits vollständig.
Beobachtungen aus der Session
Diese TDD-Session illustriert mehrere wichtige Aspekte des EXACT-Workflows:
- Minimale Prompts, maximale Kontrolle: Der Mensch gibt oft nur „j“ oder „ja“ ein — der TDD-Skill steuert den Prozess. Eingriffe erfolgen gezielt in der Refactor-Phase.
- Vorhersagbarkeit durch das „Guessing Game“: Vor jedem Testlauf macht das LLM eine Vorhersage. Stimmt sie nicht, deutet das auf ein Missverständnis hin.
- Refactoring als Dialog: Die Refactor-Phase ist der natürliche Eingriffspunkt für menschliche Entscheidungen — hier werden Naming-Konventionen und Code-Struktur diskutiert.
- Human in the Loop: Das LLM fragt nach jeder Phase um Erlaubnis. Der Mensch kann jederzeit eingreifen, korrigieren oder den Kurs ändern.
Fazit: Der Sweet Spot zwischen Produktivität und Qualität
EXACT Coding ist kein revolutionär neues Konzept — es ist eine bewusste Kombination bewährter Praktiken, die gemeinsam einen Sweet Spot ermöglichen: mehr Produktivität durch KI-Unterstützung, ohne die Kontrolle und Qualität zu opfern.
Die Kernprinzipien lassen sich in drei Punkten zusammenfassen:
- Beispiele vor Code: Example Mapping schafft gemeinsames Verständnis und eliminiert Mehrdeutigkeiten, bevor das erste Token generiert wird.
- Tests als Steuerung: Ein roter Test gibt der KI einen präzisen, begrenzten Auftrag. Das löst das „Lost in the Middle“-Problem und verhindert Overengineering.
- Mensch als Korrektiv: Checkpoints nach jeder Phase halten den Menschen im Loop, wo er die Qualität von Entscheidungen sichert, die kein LLM allein treffen kann.
Das Ergebnis ist Code, der funktioniert und zugleich verstanden, gewartet und weiterentwickelt werden kann — von Menschen, die wissen, was sie gebaut haben, und warum.